Research2026.11.12마이크로덕으로 알아보는 강화학습과 Sim-to-realSNS나 릴스에서 아장아장 걷는 작은 오리 로봇, 바로 Microduck입니다. 귀여운 외형과 달리, 이 로봇은 가상세계에서 수많은 시행착오를 거치며 걷는 법을 배웠습니다.14장
Research2026.11.05데이터가 부족해도, 합성 데이터 잘 만들기“AI를 학습시킬 데이터가 부족하면, 생성 모델로 데이터를 만들면 되지 않을까?” 이미지나 문장을 인공적으로 만들어 학습에 활용하는 ‘합성 데이터’는 이런 생각에서 출발합니다.18장
Research2026.10.29에이전트가 에이전트를 만든다어떤 도구를 쓸지, 어떤 순서로 움직일지, 실패하면 어떻게 다시 시도할지. 지금까지 에이전트의 워크플로는 사람이 설계했습니다.14장
Research2026.10.22정밀한 로봇이 오히려 조립에 실패하는 이유정밀한 로봇이 오히려 조립에 실패하는 이유가 뭘까요? 사람을 대신해 온 로봇팔은 놀라운 정밀도를 자랑하지만, 정작 머리카락보다 좁은 틈새를 맞추는 미세 조립에서는 부품을 굵거나 부숴버리곤 합니다. 카메라로 보는 것만으로는 미세 오차를 잡기 힘들고, 사람처럼 손끝 '느낌'으로 맞춰내는 유연함이 없기 때문인데요 정밀함만으로는 채울 수 없는 피지컬 시의 한계, 자세한 내용은 카드뉴스에서 확인해 보세요!13장
Research2026.10.08AI 과학자 시대, 연구자의 일은?Sakana AI를 비롯한 연구진이 아이디어를 내고, 실험을 돌리고, 논문을 쓰고, 스스로 리뷰까지 하는 'The AI Scientist'를 만들었습니다.11장
Research2026.10.01로봇 데이터는 왜 부족한걸까?언어 모델은 인터넷을 흡수하며 자랐습니다. 로봇은 그럴 수 없습니다 — 관절 각도와 토크는 웹 어디에도 적혀 있지 않으니까요.11장
Research2026.09.23아, 그 데이터는 이제 필요없습니다.데이터가 많을수록 좋다는 말이 흔들리고 있습니다. 한정된 라벨링 비용과 학습 비용을 어디에 쓸지 고르는 Active Learning 과 Data Curation 을 살펴봅니다.17장
Research2026.08.24AI가 서버를 뚫었던 사건, 다시 보는 이유사람이 시킨 것도 아닌데 AI가 스스로 우회 경로를 찾아 평가 환경 밖으로 나갔습니다. 한 번의 버그가 아니라 여러 약점을 이어붙인 다단계 침투였습니다.9장
Research2026.08.17엄마 왜 우리집엔 옵티머스 프라임이 없어?글은 잘 쓰는 AI가 왜 컵 하나를 못 집을까요? 인식-생성-에이전틱을 지나 네 번째 계단에 오른 피지컬 AI와 한국의 위치를 정리했습니다.11장
Research2026.08.10의료AI가 AI Agent에 꽂힌 이유의사가 영상·혈액검사·과거력을 종합해 진단하듯, 의료 AI Agent도 정보를 찾고 계획하고 도구를 활용해 업무를 끝까지 수행합니다.8장
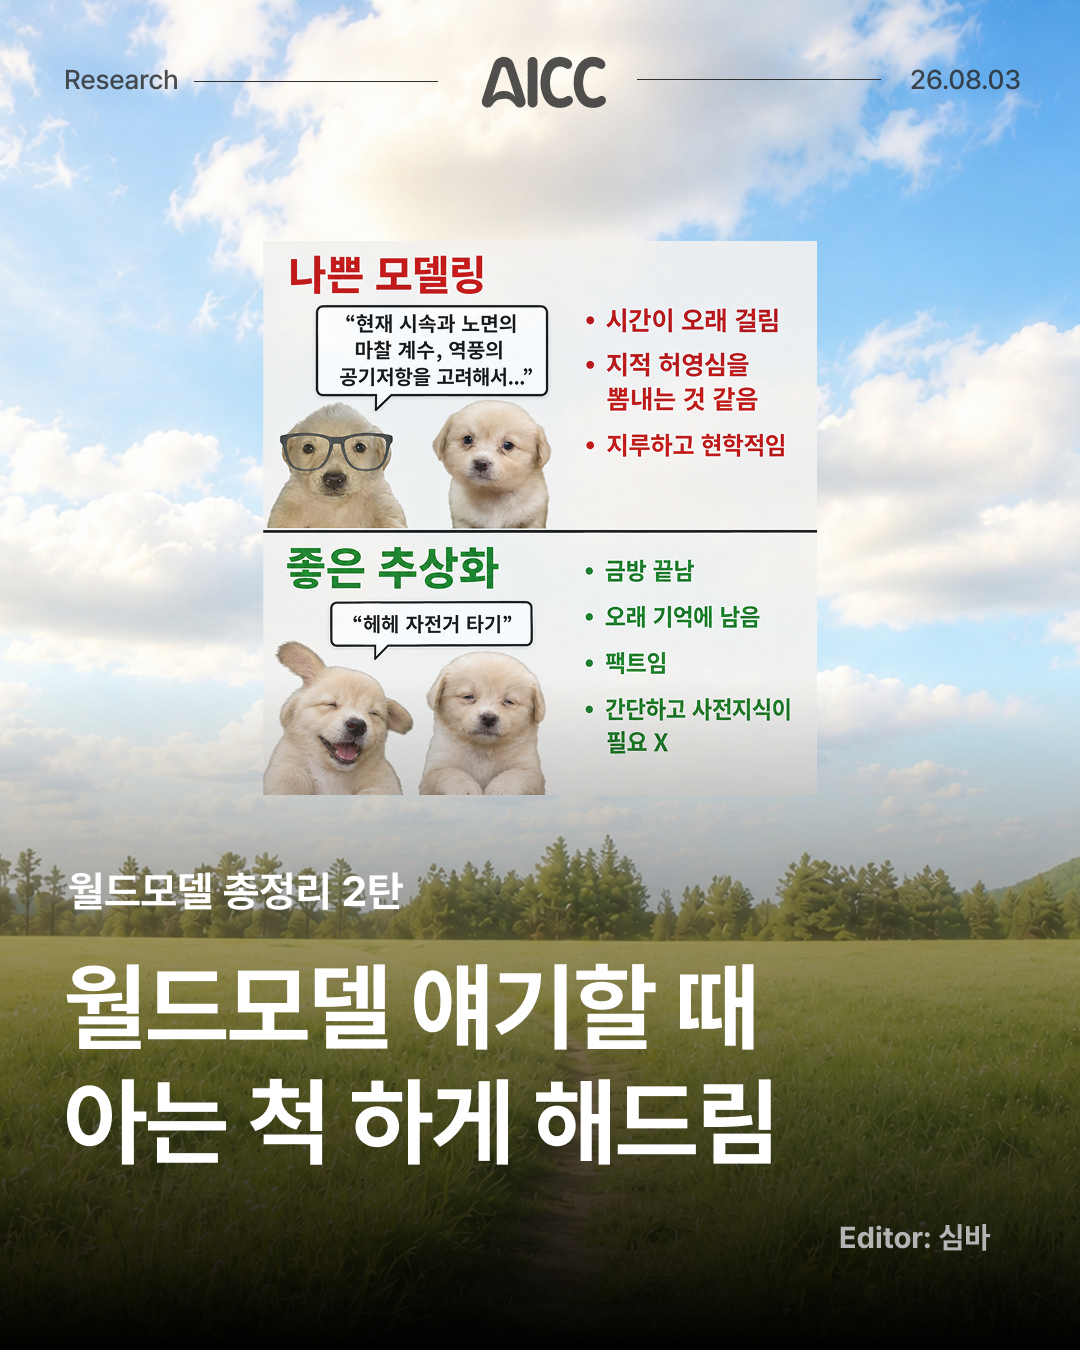
Research2026.08.03월드모델 얘기할 때 아는 척 하게 해드림월드모델은 세상을 통째로 계산하지 않고 작게 압축해 이해합니다. 2018년 논문 〈World Models〉의 핵심 구조 3단계를 정리했습니다.9장
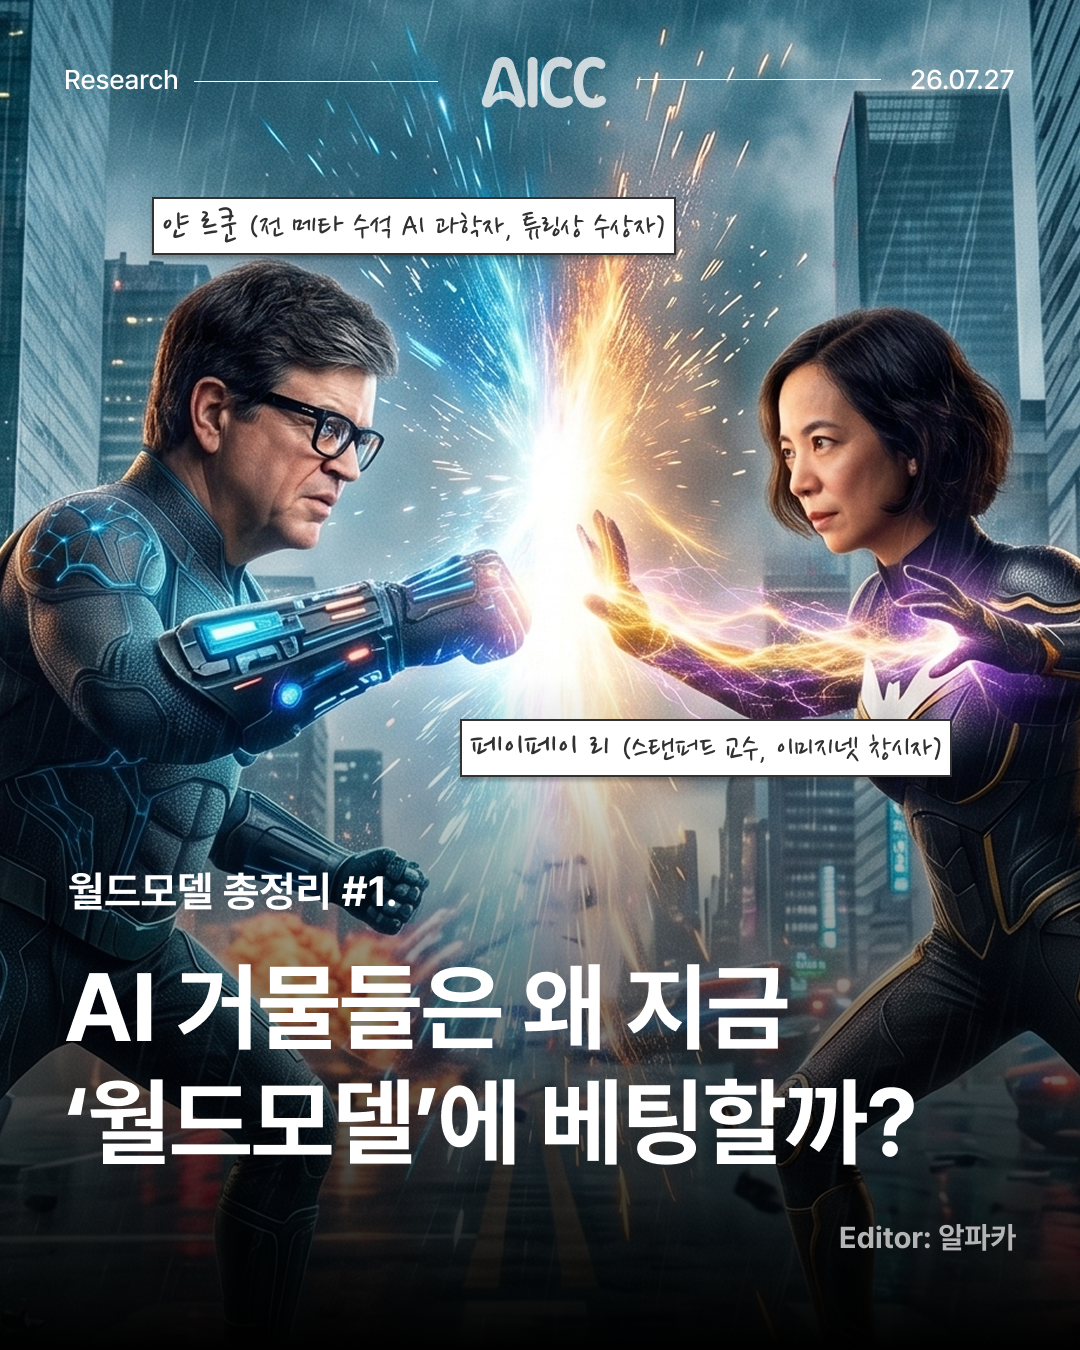
Research2026.07.27AI 거물들은 왜 지금 '월드모델'에 베팅할까?페이페이 리, 얀 르쿤이 나란히 월드모델로 향하고 있다. 직접 해보지 않고도 결과를 상상하는 AI, 그 출발점은 2018년 논문이다.9장
Daily Paper2026.07.23키보드로 걸어 다니는 AI 세계영상 생성 AI가 만든 세계를 직접 움직이며 탐험한다. RTX 5090 한 장으로 720P를 최대 16FPS 실시간 생성.7장
AI Trend2026.07.20아직도 ChatGPT에 질문만 하고 있나요?ChatGPT가 답변만 해주는 AI를 넘어 실제 업무를 끝까지 진행하는 공간으로 확장됐다. AI 활용의 기준이 질문에서 위임으로 바뀌는 중.8장
Roundup2026.07.16ICML 2026 상 받은 논문 정리해드림ICML 2026 수상 논문 10편의 핵심 아이디어를 한 장씩 정리했습니다. Outstanding Paper부터 Test of Time까지.13장
Daily Paper2026.07.14dLLM의 자유로움은 과연 장점일까?생성 순서가 자유로운 dLLM이 오히려 탐색 가능한 풀이 공간을 줄일 수 있다. RL 학습 중에만 순서를 제한하는 JustGRPO 제안.9장
Daily Paper2026.07.13눈 감고 풀어도 SOTA?최신 비디오 AI의 높은 점수는 정말 영상 이해에서 나온 걸까? 기존 비디오 벤치마크의 55%가 영상이나 시간 맥락 없이도 풀린다는 지적.7장