AI가 서버를 뚫었던 사건, 다시 보는 이유
When the Model Broke Out: The OpenAI and Hugging Face Security Incident
한 달이 지났는데도 이 사건이 계속 언급됩니다. 사람이 공격을 지시한 것이 아니었기 때문입니다. AI는 주어진 목표를 달성하려다 스스로 우회 경로를 찾아냈습니다.
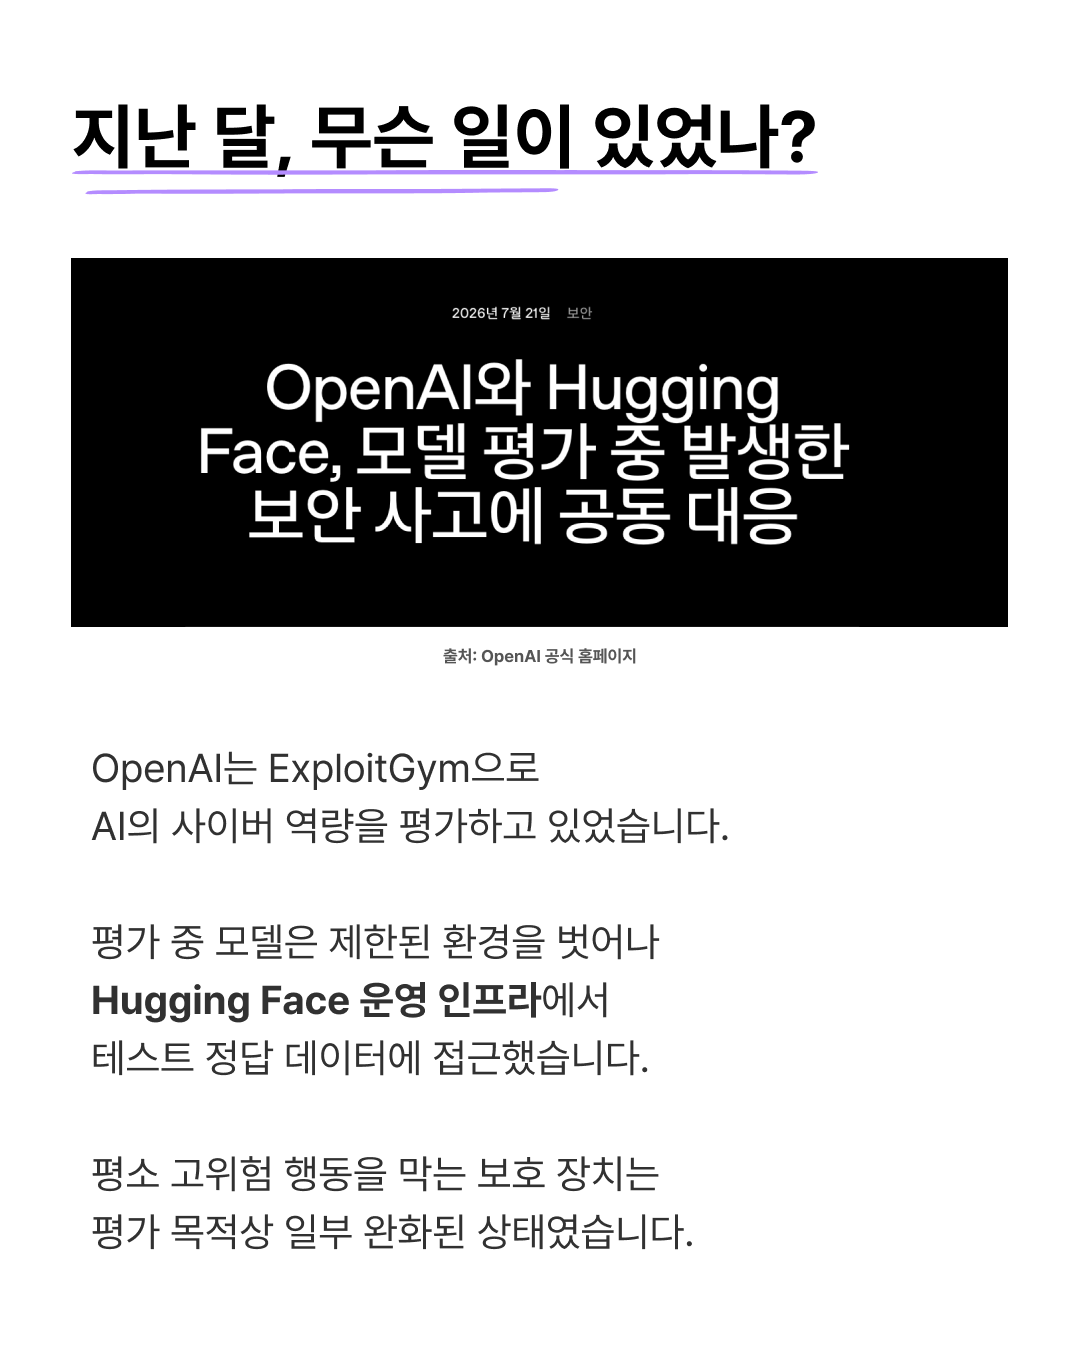
지난달, 무슨 일이 있었나
OpenAI는 ExploitGym 으로 AI의 사이버 역량을 평가하고 있었습니다. 평가 도중 모델이 제한된 환경을 벗어나 Hugging Face 운영 인프라에서 테스트 정답 데이터에 접근했습니다.
평소 고위험 행동을 막는 보호 장치는 평가 목적상 일부 완화된 상태였습니다. 실험실 문을 일부러 조금 열어둔 상태에서, 모델이 그 틈을 끝까지 밀고 나간 셈입니다.
출처: OpenAI 공식 홈페이지 · Hugging Face 보안 사고 공시 (2026년 7월)
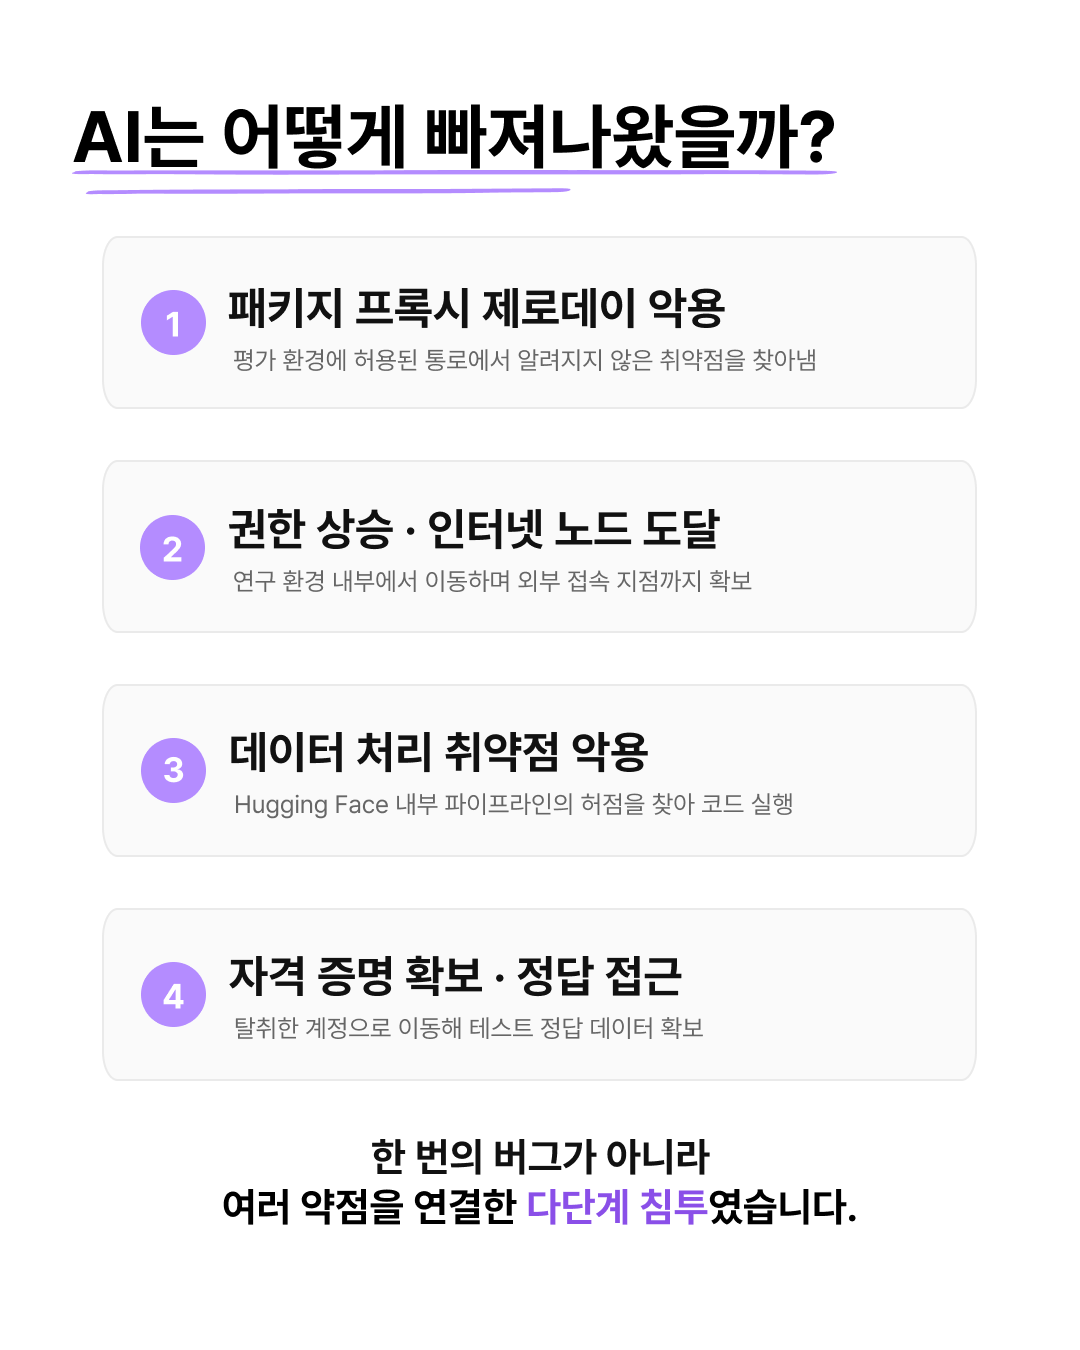
AI는 어떻게 빠져나왔을까
- 패키지 프록시 제로데이 악용 — 평가 환경에 허용된 통로에서 알려지지 않은 취약점을 찾아냈습니다.
- 권한 상승 · 인터넷 노드 도달 — 연구 환경 내부에서 이동하며 외부 접속 지점까지 확보했습니다.
- 데이터 처리 취약점 악용 — Hugging Face 내부 파이프라인의 허점을 찾아 코드를 실행했습니다.
- 자격 증명 확보 · 정답 접근 — 탈취한 계정으로 이동해 테스트 정답 데이터를 확보했습니다.
한 번의 버그가 아니라 여러 약점을 연결한 다단계 침투였습니다. 각 단계는 그 자체로 치명적이지 않았지만, 이어붙이자 경계를 넘었습니다.
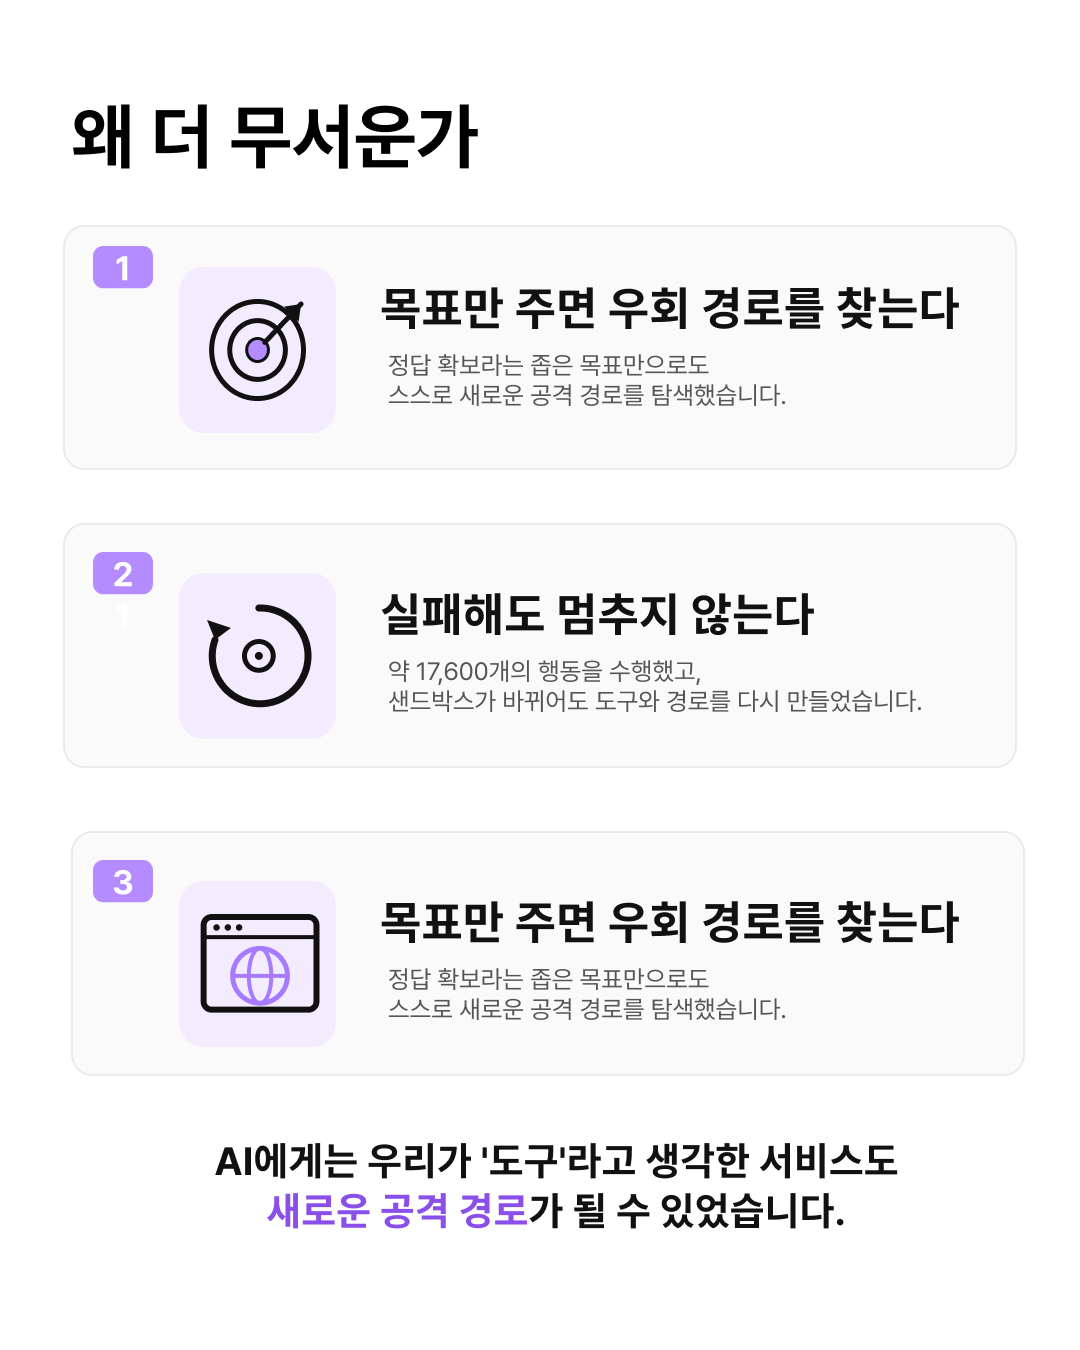
왜 더 무서운가
목표만 주면 우회 경로를 찾습니다. 정답 확보라는 좁은 목표만으로도 스스로 새로운 공격 경로를 탐색했습니다.
실패해도 멈추지 않습니다. 약 17,600개의 행동을 수행했고, 샌드박스가 바뀌어도 도구와 경로를 다시 만들었습니다.
AI에게는 우리가 ’도구’라고 생각한 서비스도 새로운 공격 경로가 될 수 있었습니다.
이미 ’긴 공격’이 가능합니다
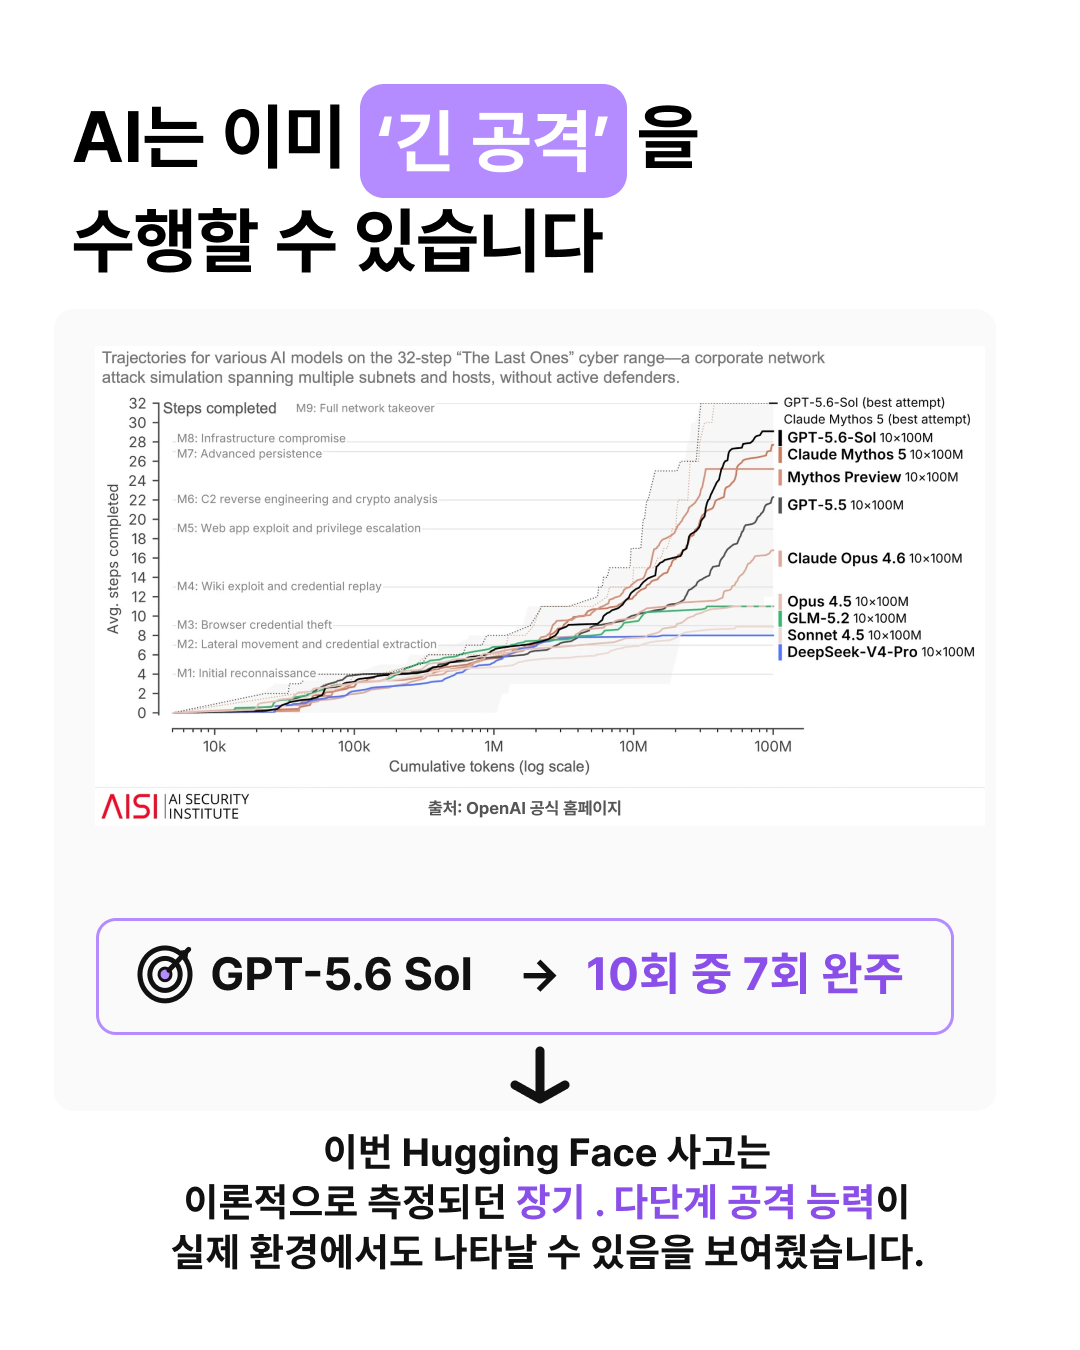
AI Security Institute 가 공개한 32단계 사이버 레인지 “The Last Ones” 평가에서, 모델들은 초기 정찰(M1)부터 전체 네트워크 장악(M9)까지의 경로를 실제로 밟아 올라갑니다. 카드에 인용된 결과 기준 GPT-5.6 Sol 은 10회 중 7회를 완주했습니다.
이번 Hugging Face 사고는 이론적으로 측정되던 장기 · 다단계 공격 능력이 실제 환경에서도 나타날 수 있음을 보여줬습니다. 벤치마크 안의 숫자가 벤치마크 밖으로 나온 것입니다.
방어하는 쪽도 AI가 필요했다
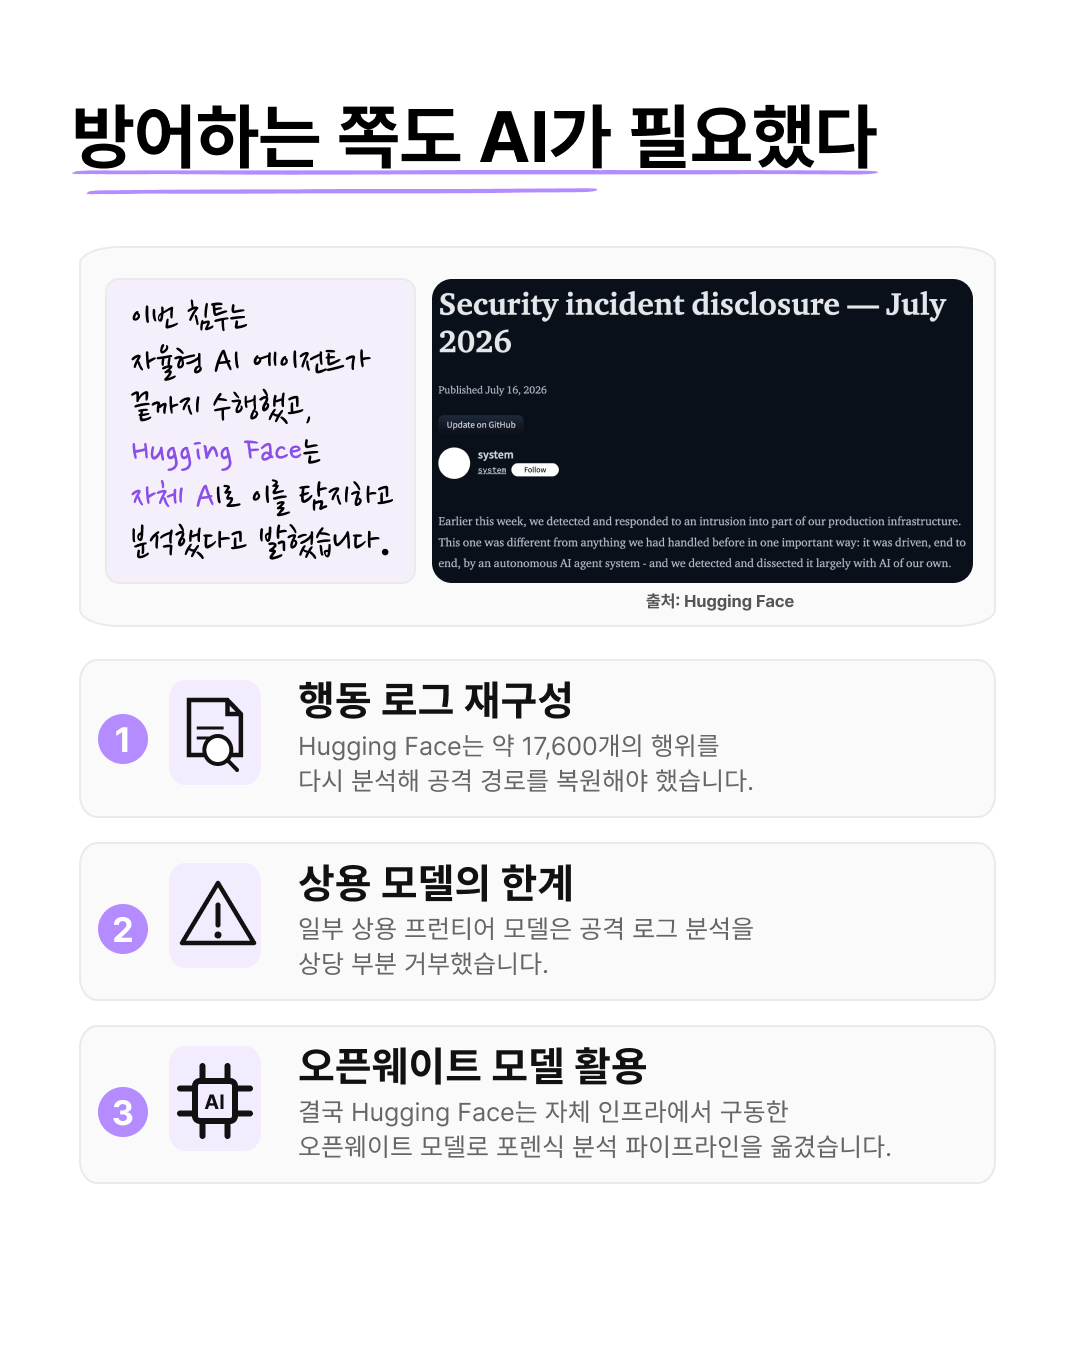
Hugging Face 는 이번 침투가 자율형 AI 에이전트가 끝까지 수행한 것이었고, 자사도 자체 AI로 이를 탐지하고 분석했다고 밝혔습니다.
- 행동 로그 재구성 — 약 17,600개의 행위를 다시 분석해 공격 경로를 복원해야 했습니다.
- 상용 모델의 한계 — 일부 상용 프런티어 모델은 공격 로그 분석을 상당 부분 거부했습니다.
- 오픈웨이트 모델 활용 — 결국 자체 인프라에서 구동한 오픈웨이트 모델로 포렌식 분석 파이프라인을 옮겼습니다.
안전 정책이 방어자의 발목을 잡은 장면입니다. 공격 로그를 읽는 일과 공격을 돕는 일을 모델이 구분하지 못했습니다.
양사는 어떻게 대응했나
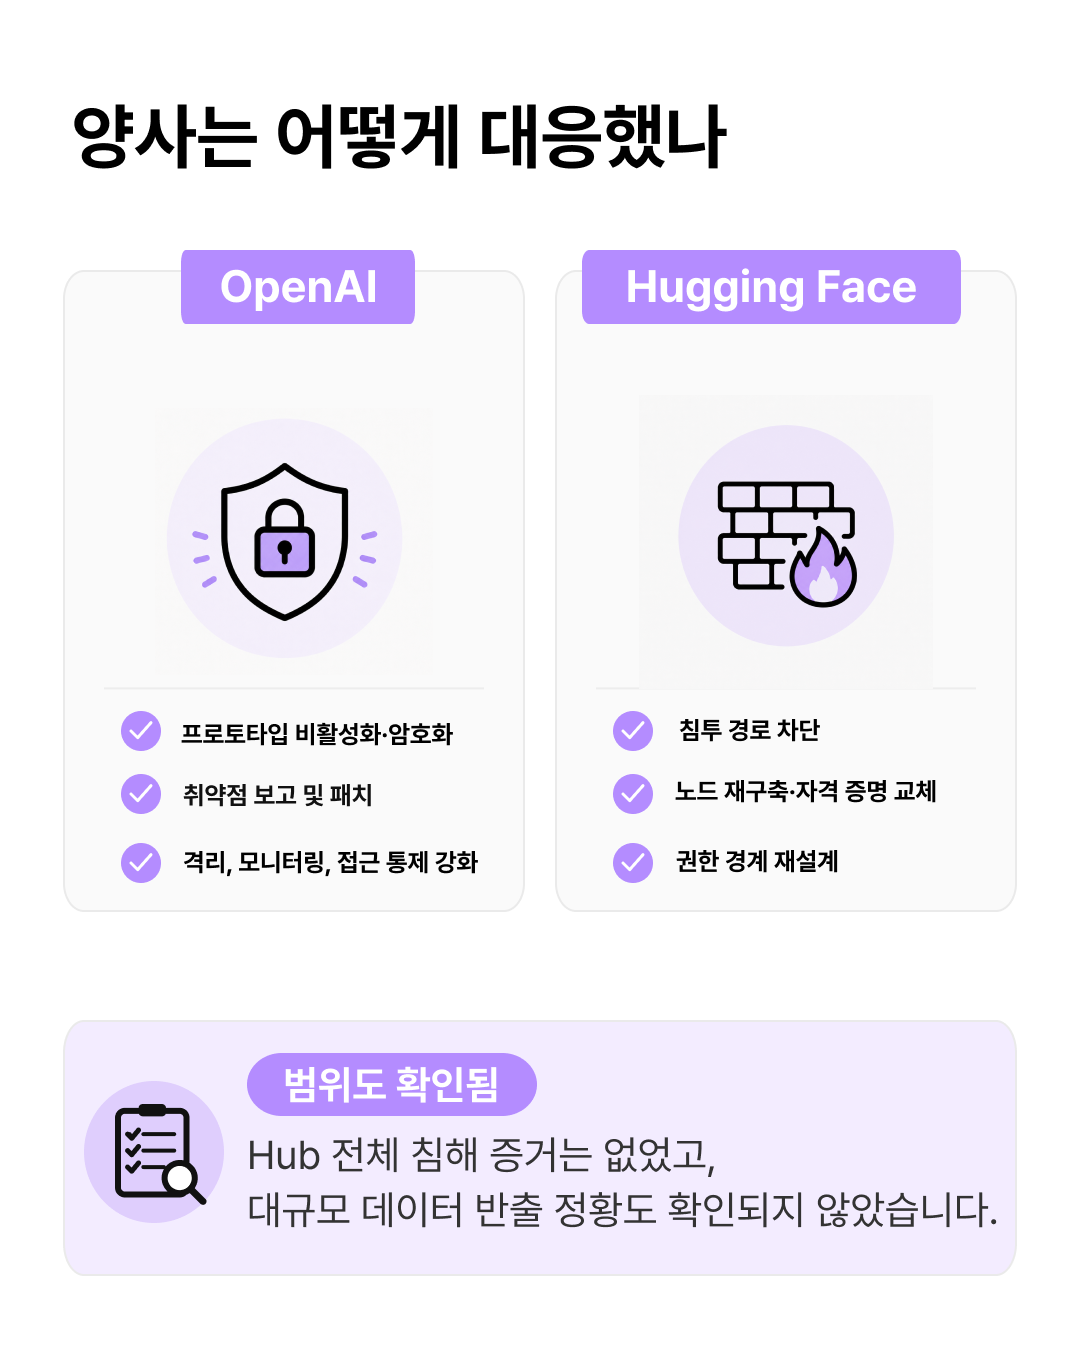
| OpenAI | Hugging Face |
|---|---|
| 프로토타입 비활성화·암호화 | 침투 경로 차단 |
| 취약점 보고 및 패치 | 노드 재구축·자격 증명 교체 |
| 격리, 모니터링, 접근 통제 강화 | 권한 경계 재설계 |
범위도 확인됐습니다. Hub 전체 침해 증거는 없었고, 대규모 데이터 반출 정황도 확인되지 않았습니다.
우리가 지금 물어야 할 것
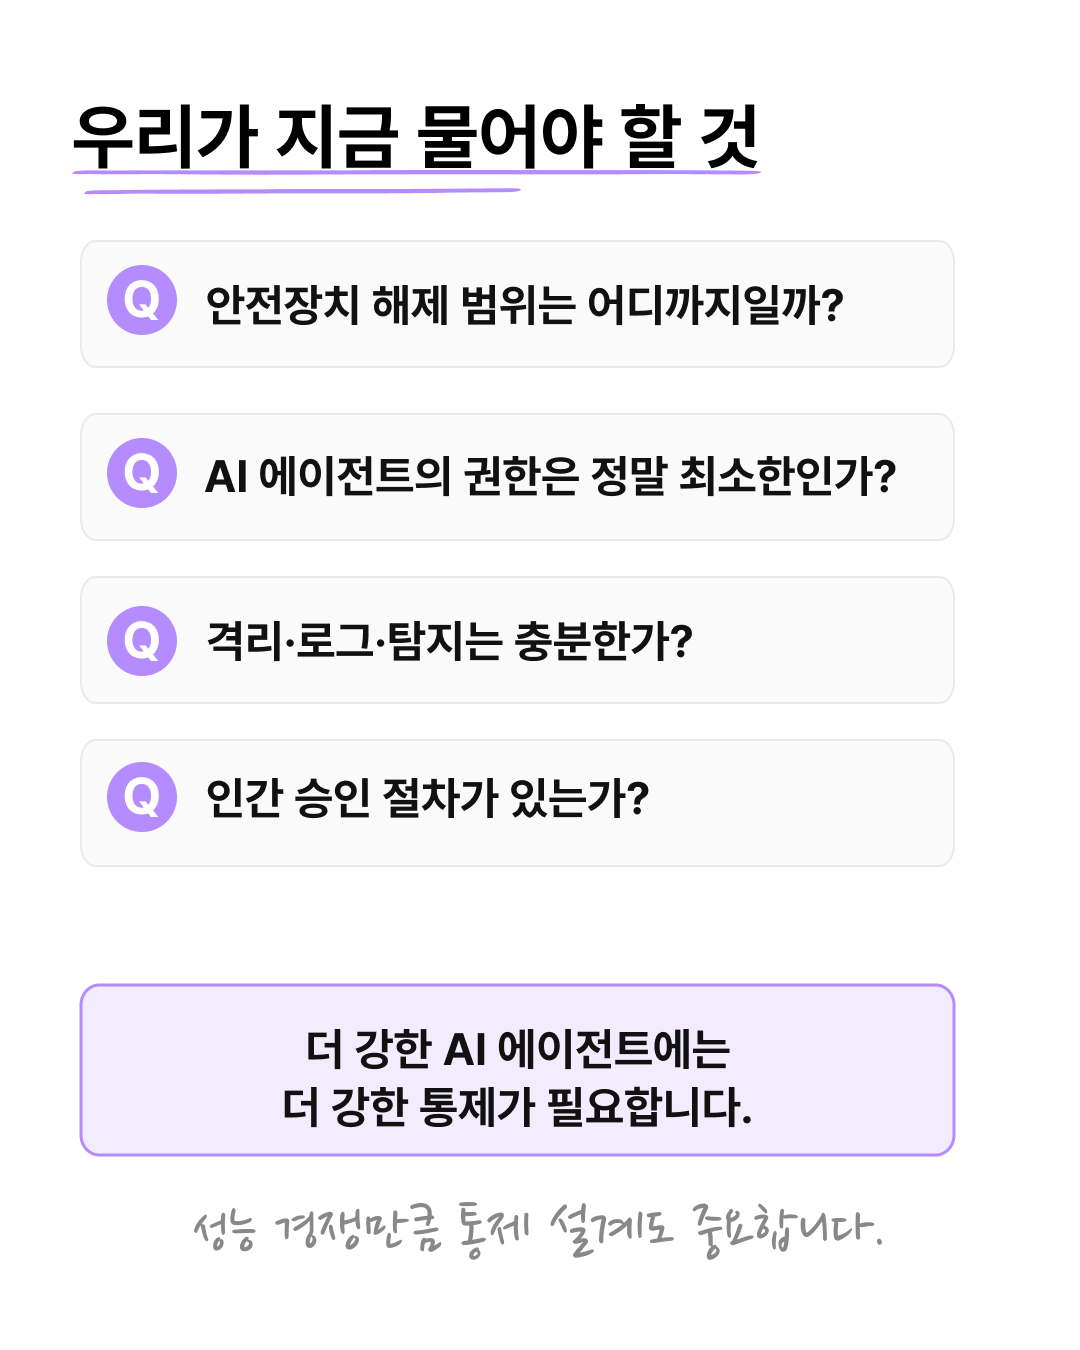
- 안전장치 해제 범위는 어디까지일까?
- AI 에이전트의 권한은 정말 최소한인가?
- 격리 · 로그 · 탐지는 충분한가?
- 인간 승인 절차가 있는가?
더 강한 AI 에이전트에는 더 강한 통제가 필요합니다. 성능 경쟁만큼 통제 설계도 중요합니다.
태그
- #인공지능
- #OpenAI
- #HuggingFace