데이터가 범람합니다
2020년 OpenAI는 「Scaling Laws for Neural Language Models」라는 기술 레포트에서 모델의 크기와 학습 데이터, 그리고 연산량을 늘릴수록 모델의 성능이 향상된다는 결과를 보여주었습니다. 이후 실제 AI의 발전 역시 인터넷 규모의 방대한 데이터를 학습하며 이전보다 훨씬 뛰어난 성능을 보여주기 시작했습니다.
하지만 최근에는 단순히 “데이터가 많을수록 좋다”고 말하기 어려워졌습니다. 이유는 간단합니다. 데이터가 정말 너무 많아졌기 때문입니다. 수집할 수 있는 데이터는 빠르게 늘어나지만, 사람이 붙일 수 있는 라벨의 수와 모델 학습에 사용할 수 있는 연산 자원은 한정되어 있습니다.
그렇다면 모든 데이터를 사용할 수 없을 때, 어떤 데이터를 골라야 할까요?
어떤 데이터에 사람의 비용을 들여 annotation할 것인지, 수많은 데이터 가운데 어떤 데이터를 실제로 학습에 사용할 것인지가 중요한 문제가 된 것입니다. 이 질문은 사실 머신러닝 연구에서 오래전부터 다뤄져 왔습니다. Active Learning부터 Data Curation까지 여러 방면으로 연구되어 온 기술들이 최근에는 ‘Data Engine’ 이라는 하나의 산업적 흐름으로 연결되고 있습니다.
라벨링 비용을 줄이려면: Active Learning
AI 학습에서 오래전부터 큰 문제였던 것 중 하나는 라벨링 비용입니다. 이미지는 수백만 장 모을 수 있어도, 모든 이미지에 사람이 정답을 붙이는 일은 쉽지 않습니다. 특히 의료영상처럼 전문가의 판단이 필요한 데이터는 비용이 훨씬 더 커집니다.
그럼 아직 정답이 없는 데이터 중 어떤 데이터부터 답지를 만들고 모델에 학습시켜야 할까요?
그렇게 등장한 것이 Active Learning입니다. 사람이 능동적으로 자신이 잘 모르는 것을 배우는 것처럼, 모델이 필요로 하는 데이터는 무엇일 지 파악해서 해당 샘플을 라벨링하자는 제안을 하게 됩니다. 그래서 모델이 이미 잘 아는 샘플들에 계속 라벨을 붙이는 대신, 모델이 헷갈려하거나 전체 데이터 분포를 잘 대표할 수 있도록 만드는 샘플을 선택하는 방식입니다.
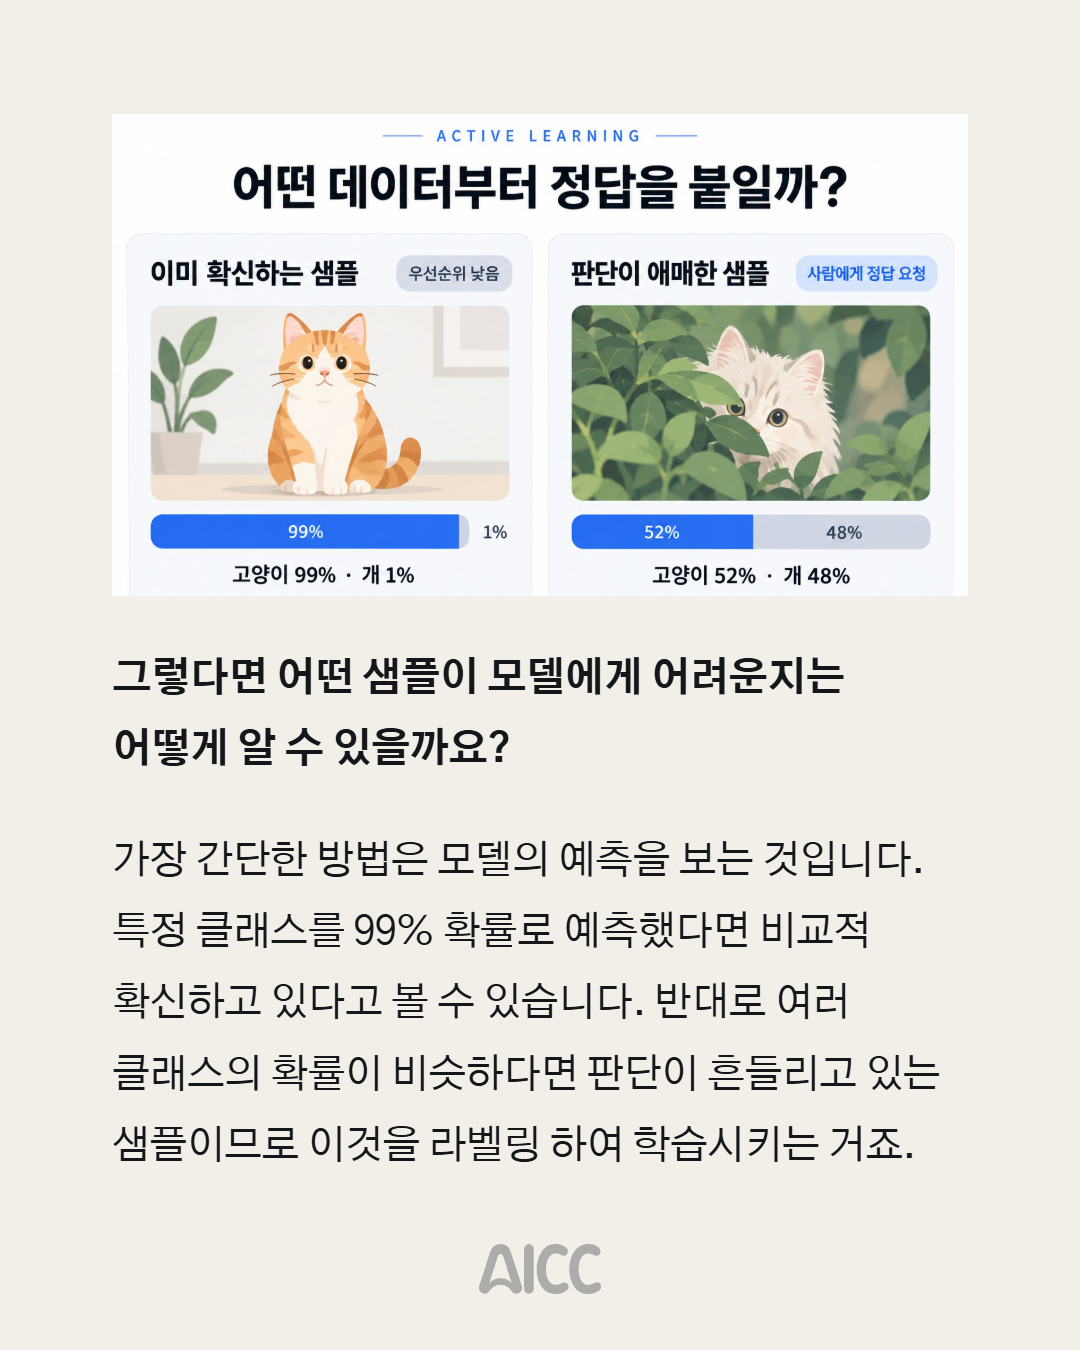
그렇다면 어떤 샘플이 모델에게 어려운지는 어떻게 알 수 있을까요?
가장 간단한 방법은 모델의 예측을 보는 것입니다. 특정 클래스를 99% 확률로 예측했다면 비교적 확신하고 있다고 볼 수 있습니다. 반대로 여러 클래스의 확률이 비슷하다면 판단이 흔들리고 있는 샘플이므로 이것을 라벨링 하여 학습시키는 거죠.
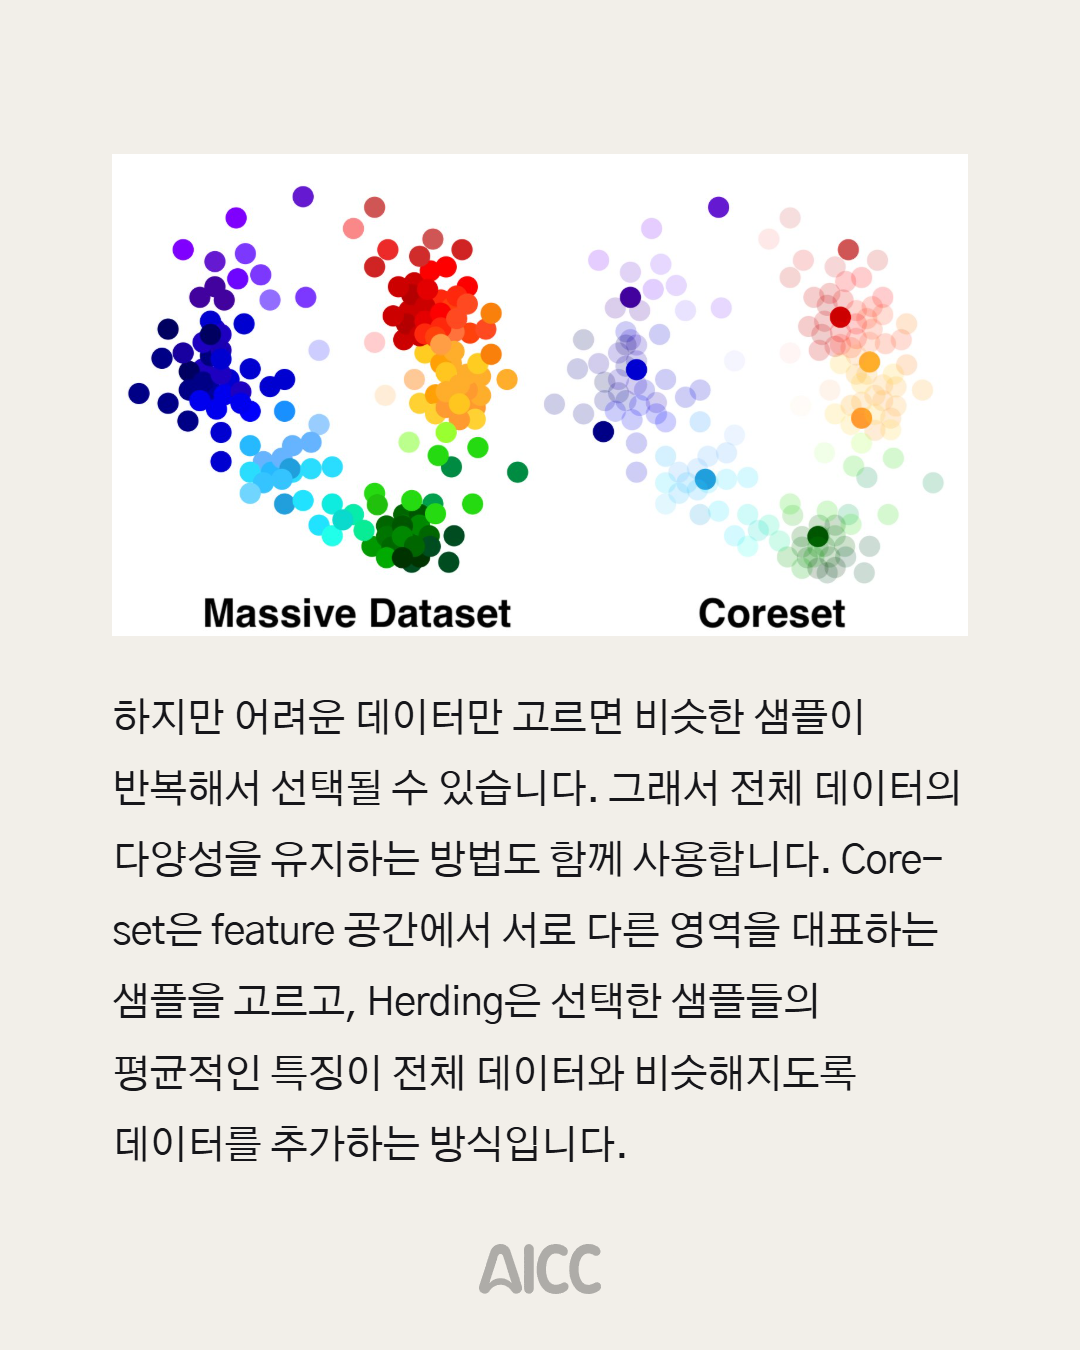
하지만 어려운 데이터만 고르면 비슷한 샘플이 반복해서 선택될 수 있습니다. 그래서 전체 데이터의 다양성을 유지하는 방법도 함께 사용합니다. Core-set은 feature 공간에서 서로 다른 영역을 대표하는 샘플을 고르고, Herding은 선택한 샘플들의 평균적인 특징이 전체 데이터와 비슷해지도록 데이터를 추가하는 방식입니다.
이런 방법들이 실제 산업에서 유용하게 활용됩니다. 데이터는 계속 쌓이지만 예산 때문에 일부밖에 라벨링할 수 없다면, 어떤 샘플부터 학습시킬 지 우선순위를 매겨 먼저 라벨링하는 식으로 활용하게 됩니다. 이렇게 제한된 라벨링 비용으로 최대한의 성능 향상을 얻기 위해 Active Learning을 활용하고 있습니다.
모든 데이터를 학습해야 할까? : Data Curation
라벨링 비용만 줄인다고 데이터 문제가 끝나는 것은 아닙니다. 이번에는 반대로 데이터가 너무 많아진 상황이 문제가 됩니다.
우리는 인터넷에서 수십억 개의 이미지와 글을 수집할 수 있습니다. 하지만 모델이 이 모든 데이터를 학습하려면 엄청난 GPU와 시간이 필요합니다. 게다가 모든 데이터가 새롭고 유익한 정보를 담고 있지도 않습니다. 같은 이미지나 문서가 반복되기도 하고, 품질이 낮거나 이미지와 설명이 잘못 연결된 데이터도 섞여 있을 겁니다.
그렇다면 어떤 데이터를 학습시켜야 할까요? 이 질문을 다루는 것이 Data Curation입니다. 중복된 데이터를 제거하고, 품질이 낮은 샘플을 걸러내고, 전체 데이터에서 학습에 도움이 될 만한 데이터를 골라내는 방식입니다. 결국 한정된 학습 비용을 가치가 높은 데이터에 집중하는 것이죠.
먼저 2023년 발표된 SemDeDup은 중복을 줄이는 데 집중했습니다. 단순히 똑같은 파일을 찾아 없애는 것이 아니라, 모델의 embedding을 이용해 내용과 특징이 비슷한 데이터까지 semantic duplicate로 찾아내는 방식입니다. 이런 접근으로 데이터의 약 절반을 제거하고도 성능을 대부분 유지하면서 학습 시간을 크게 줄일 수 있었습니다.
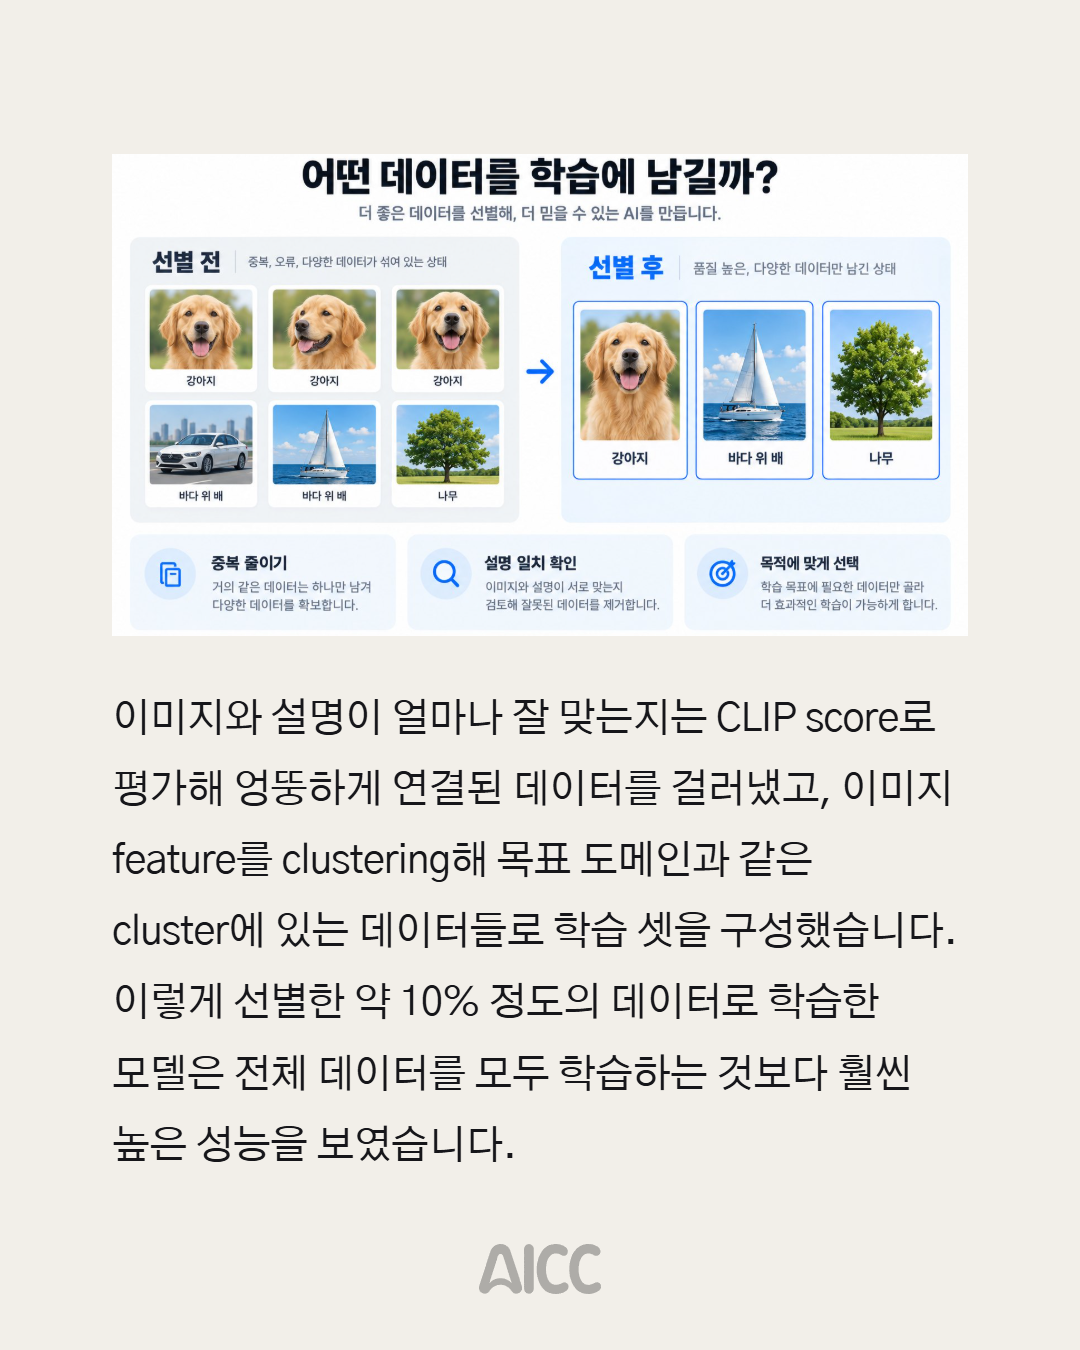
중복을 제거한 뒤엔 “어떤 데이터가 실제 학습에 도움이 되는가” 라는 질문이 생기는데요. DataComp에서는 128억 개의 이미지-텍스트 쌍을 준비한 뒤, 모델과 계산 비용은 그대로 두고 어떤 데이터를 골라 학습시키는지만 바꿨습니다.
이미지와 설명이 얼마나 잘 맞는지는 CLIP score로 평가해 엉뚱하게 연결된 데이터를 걸러냈고, 이미지 feature를 clustering해 목표 도메인과 같은 cluster에 있는 데이터들로 학습 셋을 구성했습니다. 이렇게 선별한 약 10% 정도의 데이터로 학습한 모델은 전체 데이터를 모두 학습하는 것보다 훨씬 높은 성능을 보였습니다.
결국 중요한 건, 더 많이가 아니라 더 잘
Active Learning과 Data Curation은 서로 다른 문제에서 출발했습니다. 하나는 한정된 라벨링 비용을 어디에 쓸 것인가, 다른 하나는 한정된 학습 비용을 어떤 데이터에 쓸 것인가를 고민합니다. 하지만 결국 두 연구가 던지는 질문은 비슷합니다.
“모델에게 지금 가장 가치 있는 데이터는 무엇인가?”
이 질문이 중요해진 이유는 AI가 다루는 데이터의 규모가 커졌기 때문입니다. 데이터가 부족했던 시기에는 최대한 많이 모으는 것이 중요했다면, 이제는 그 안에서 무엇을 남기고 무엇을 버릴지 결정하는 능력이 점점 더 중요해지고 있습니다.
결국 AI의 데이터 경쟁은 누가 한정된 데이터와 비용에서 더 많은 학습 신호를 끌어낼 수 있는가를 겨루고 있습니다.
태그
- #인공지능
- #AI논문
- #ActiveLearning
- #DataCuration
- #스케일링법칙
- #학습데이터