LLM과 다르게 데이터가 부족한 이유
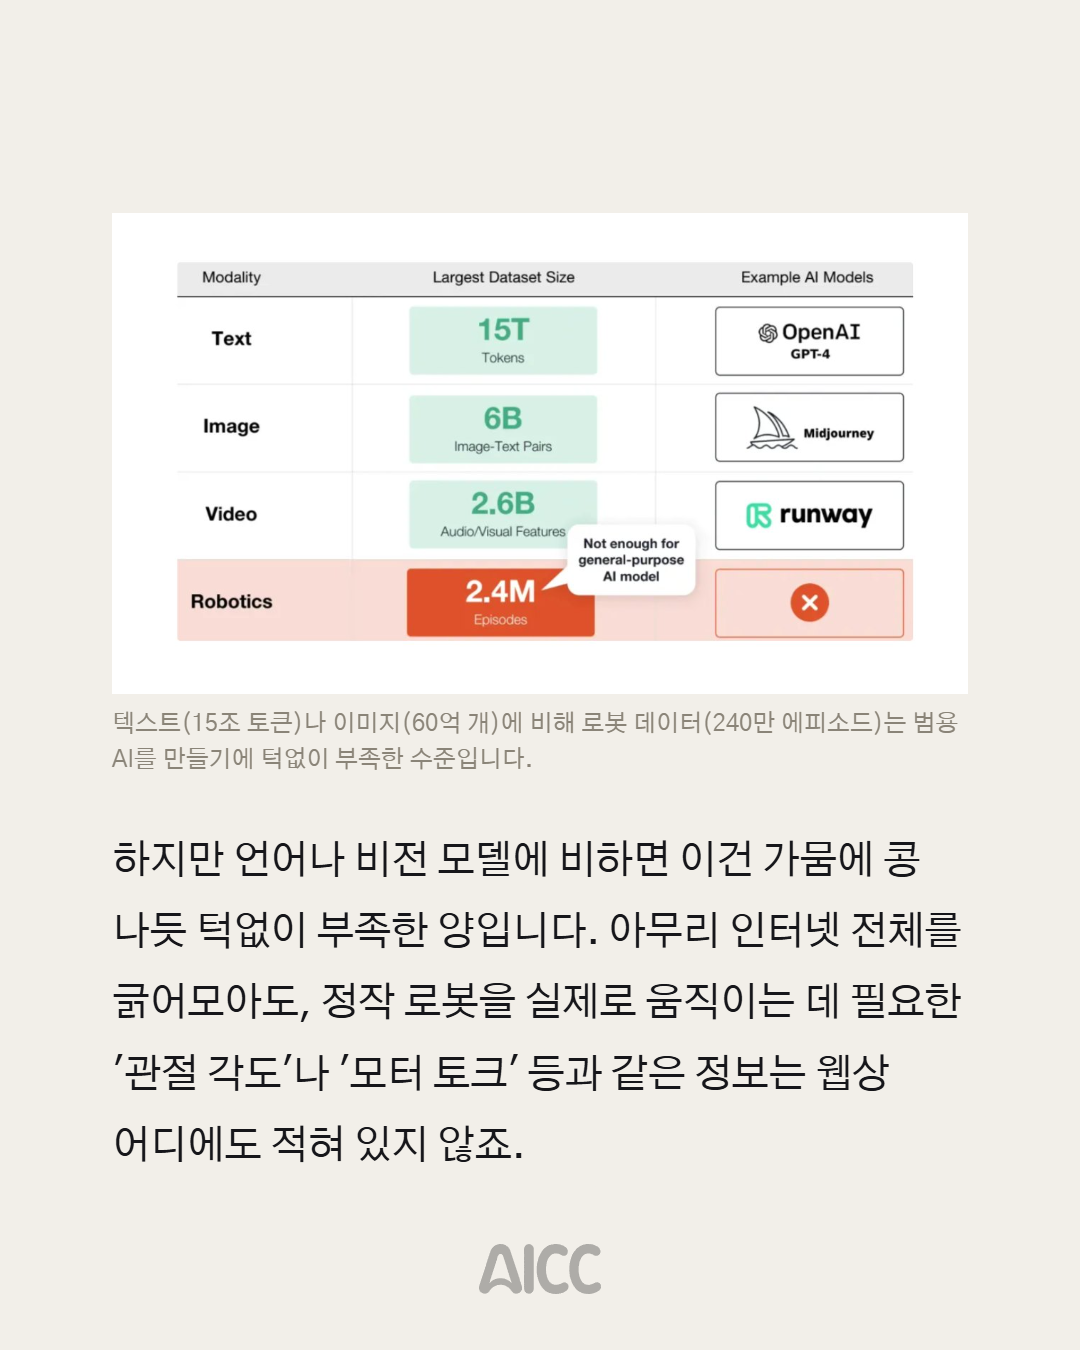
LLM이 지금처럼 눈부시게 성장할 수 있었던 비결은 결국 ‘데이터의 힘’이었습니다. OpenAI가 증명한 스케일링 로(Scaling Laws)에 따라, 인터넷에 널린 수조 개의 텍스트와 이미지를 흡수하며 성장했죠. 최근 공개된 OpenVLA 같은 VLA(Vision-Language-Action) 모델도 약 97만 개(970k)의 로봇 에피소드를 학습하며 피지컬 AI의 가능성을 보여주기 시작했습니다.
하지만 언어나 비전 모델에 비하면 이건 가뭄에 콩 나듯 턱없이 부족한 양입니다. 아무리 인터넷 전체를 긁어모아도, 정작 로봇을 실제로 움직이는 데 필요한 ‘관절 각도’나 ‘모터 토크’ 등과 같은 정보는 웹상 어디에도 적혀 있지 않죠.
가장 직관적인 해법, 사람이 가르치기
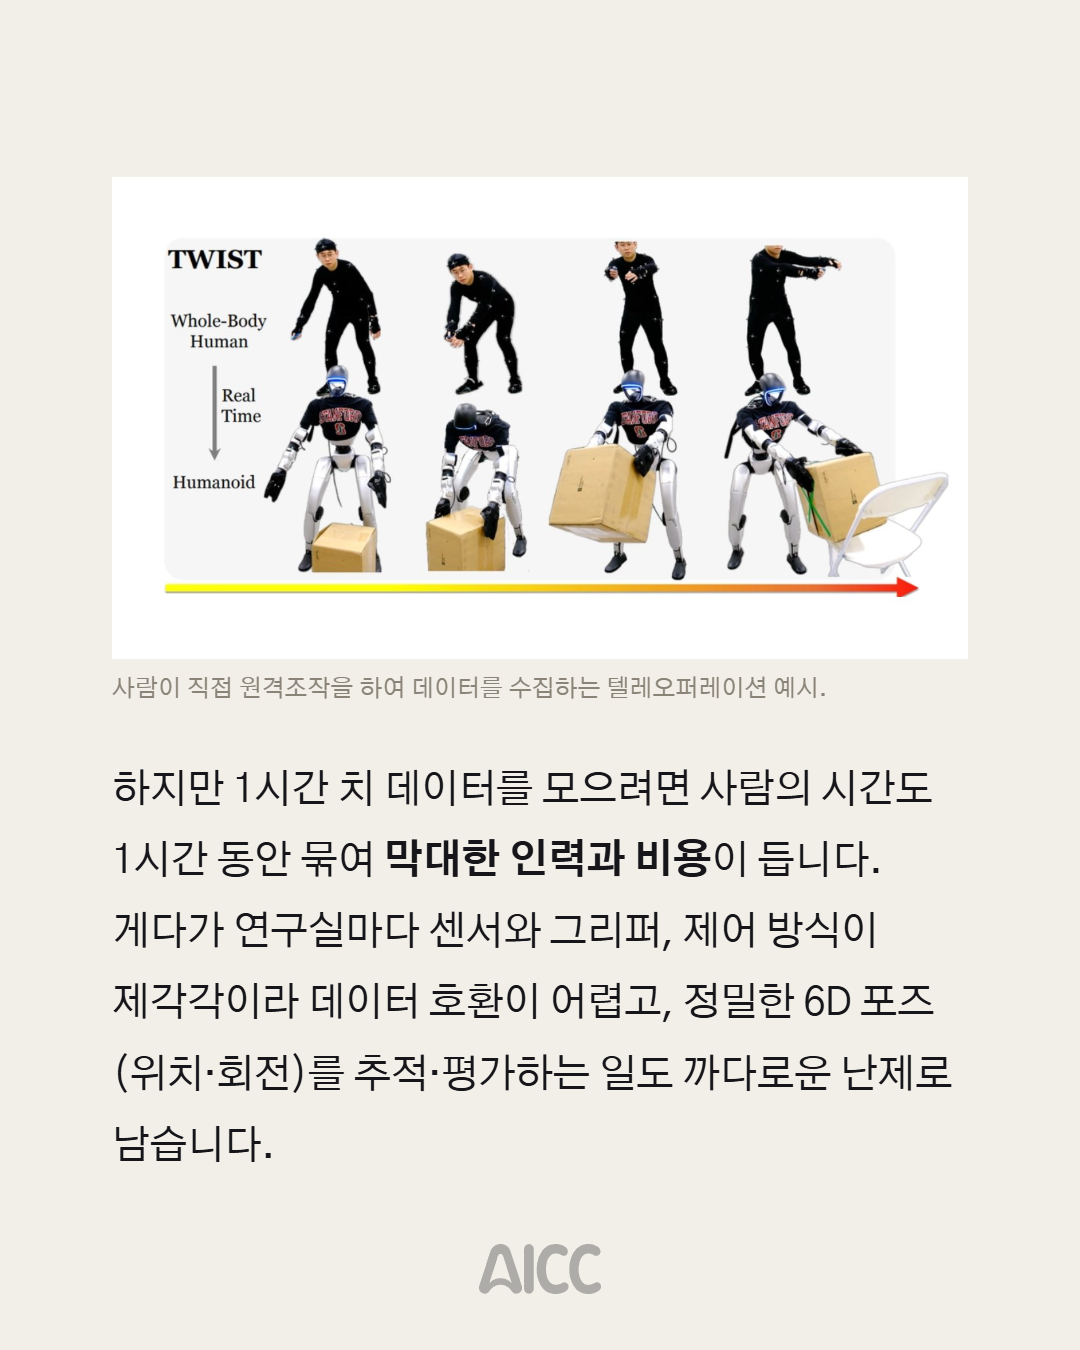
로봇에게 데이터를 가르쳐 주는 가장 직관적인 방법은 사람이 직접 시범을 보여주는 것입니다. 이를 원격 조작(Teleoperation)이라고 부르죠. 사람이 VR 글래스나 조이스틱, 모션 슈트를 착용하고 로봇을 1:1로 직접 움직여 동작 데이터를 쌓는 방식입니다.
하지만 1시간 치 데이터를 모으려면 사람의 시간도 1시간 동안 묶여 막대한 인력과 비용이 듭니다. 게다가 연구실마다 센서와 그리퍼, 제어 방식이 제각각이라 데이터 호환이 어렵고, 정밀한 6D 포즈(위치·회전)를 추적·평가하는 일도 까다로운 난제로 남습니다.
그렇다면 시뮬레이션으로 데이터를 만들면 되지 않을까?
사람을 일일이 투입하는 데 한계를 느낀 연구진은 가상 세계인 시뮬레이터로 눈을 돌렸습니다. 가상 공간에서 로봇을 무한히 돌려 데이터를 스스로 생성하게 만든다면 무한한 확장성을 얻을 수 있을 거라 기대한 것이죠. 하지만 물리 세계를 가상으로 옮겨오는 일 역시 만만치 않은 난관이 기다리고 있었습니다.
단순한 ‘컵 옮기기(Pick & Place)’ 동작만 해도, 가상 환경을 구축하려면 물체의 질량·마찰계수·중력 같은 변수를 일일이 세팅해야 합니다. 물체를 집을 때 발생하는 미세한 접촉과 미끄러짐까지 밀리초(ms) 단위로 밀도 있게 연산해야 하죠.
문제는 이렇게 가상 세계를 만들어도 현실과의 거대한 격차인 Sim-to-Real Gap이 발생한다는 점입니다. 물리 엔진 오차 때문에 실제 현실로 가져오면 오류가 생기기 쉽고, 특히 옷감이나 액체 같은 비정형 물체(Non-rigid)의 미세한 움직임은 현재 시뮬레이터로 완벽히 모사하기 불가능에 가깝습니다.
판을 바꾸는 차세대 Data Engine
결국 연구진은 데이터를 수집하는 파이프라인 자체를 원점에서 다시 설계하기 시작했습니다. 첫 번째 돌파구는 ‘시뮬레이션의 자급자족’입니다. 사람이 가상 환경을 일일이 만들던 방식에서 벗어나, 생성형 AI와 LLM을 활용해 3D 환경부터 물체, 로봇의 과제, 제어 정책까지 무한히 자동 생성하는 RoboGen과 AutoRT 기술이 등장했습니다. 사람의 개입 없이도 학습 데이터를 가상 공간에서 스스로 쏟아내는 구조를 구축한 것입니다.
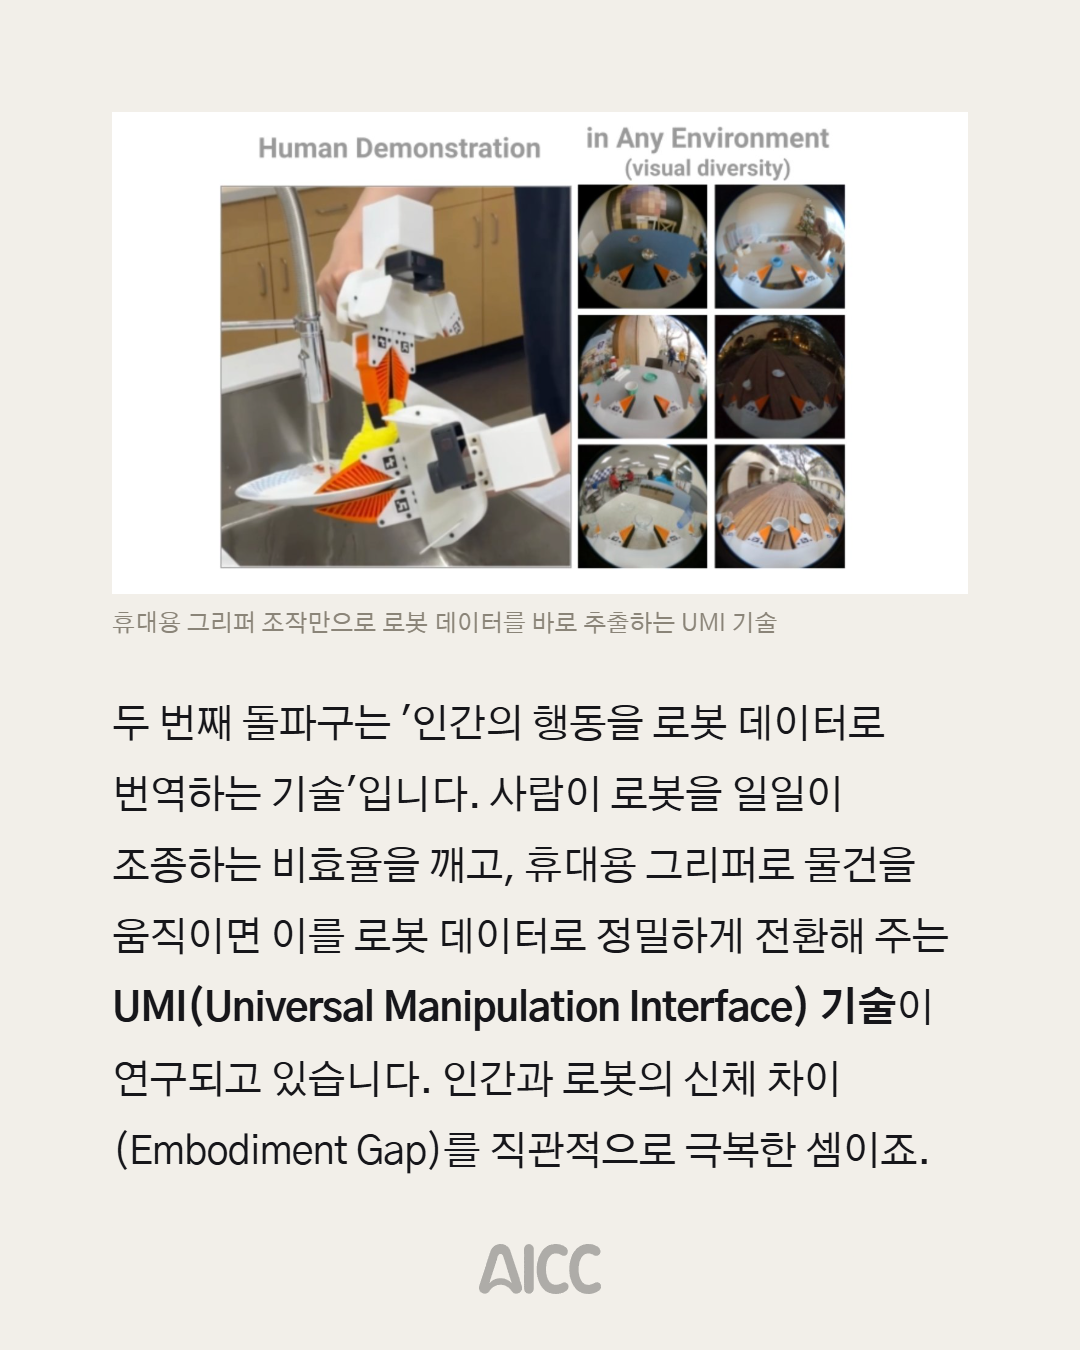
두 번째 돌파구는 ‘인간의 행동을 로봇 데이터로 번역하는 기술’입니다. 사람이 로봇을 일일이 조종하는 비효율을 깨고, 휴대용 그리퍼로 물건을 움직이면 이를 로봇 데이터로 정밀하게 전환해 주는 UMI(Universal Manipulation Interface) 기술이 연구되고 있습니다. 인간과 로봇의 신체 차이(Embodiment Gap)를 직관적으로 극복한 셈이죠.
‘더 많이’가 아니라 ‘더 똑똑하게’
언어 모델의 시대가 ‘인터넷을 얼마나 잘, 많이 긁어오느냐’의 싸움이었다면, 로봇 AI의 시대는 ‘물리적 한계를 넘어 유용한 제어 신호를 얼마나 똑똑하게 만들어내느냐’의 싸움이 될 수 있겠죠. 가상 환경을 스스로 구축하는 AI와 인간의 행동을 로봇 언어로 번역하는 데이터 엔진이 완성되는 날, 비로소 로봇 생태계에도 진짜 ‘ChatGPT 모멘트’가 찾아오지 않을까요?
태그
- #인공지능
- #AI논문
- #피지컬AI
- #로봇
- #로봇데이터
- #VLA
- #SimToReal