지난 편에서는 월드모델이 왜 필요한지 알아봤는데요. 이번 편에서는 월드모델의 시초로 불리는 2018년 논문 〈World Models〉의 핵심 구조를 살펴보겠습니다.
세상을 압축해서 이해한다는 것
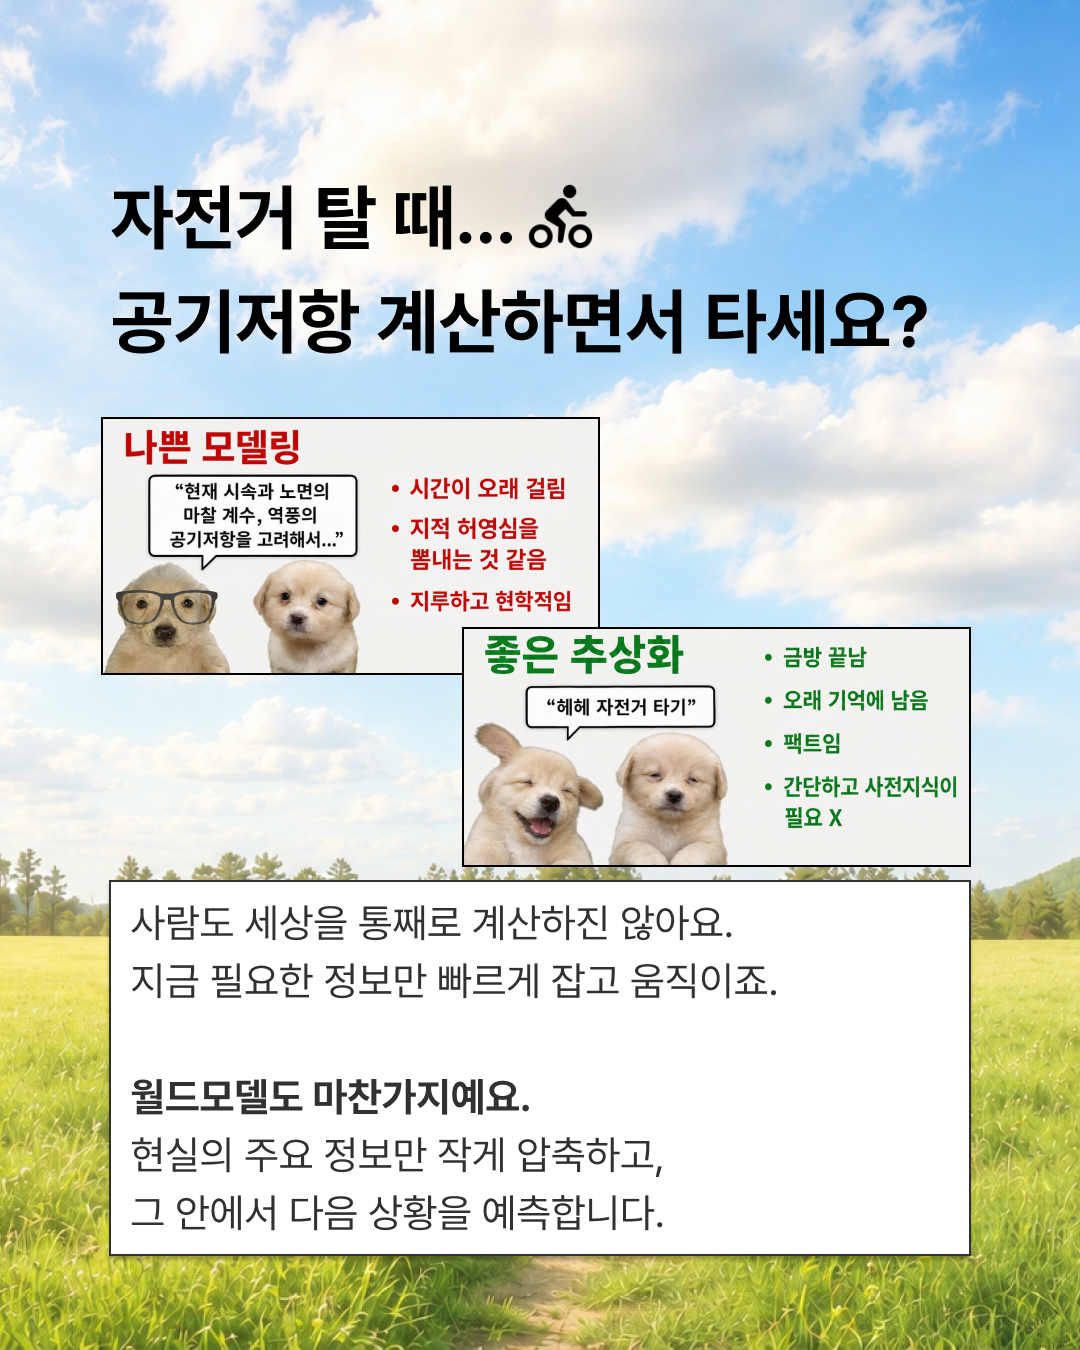
자전거를 탈 때 시속과 노면 마찰 계수, 공기저항을 계산하는 사람은 없습니다. “헤헤 자전거 타기” 정도로 충분하죠.
사람도 세상을 통째로 계산하지 않습니다. 지금 필요한 정보만 빠르게 잡고 움직일 뿐이죠. 월드모델도 마찬가지입니다. 현실의 주요 정보만 작게 압축하고, 그 안에서 다음 상황을 예측합니다.
Vision · Memory · Controller
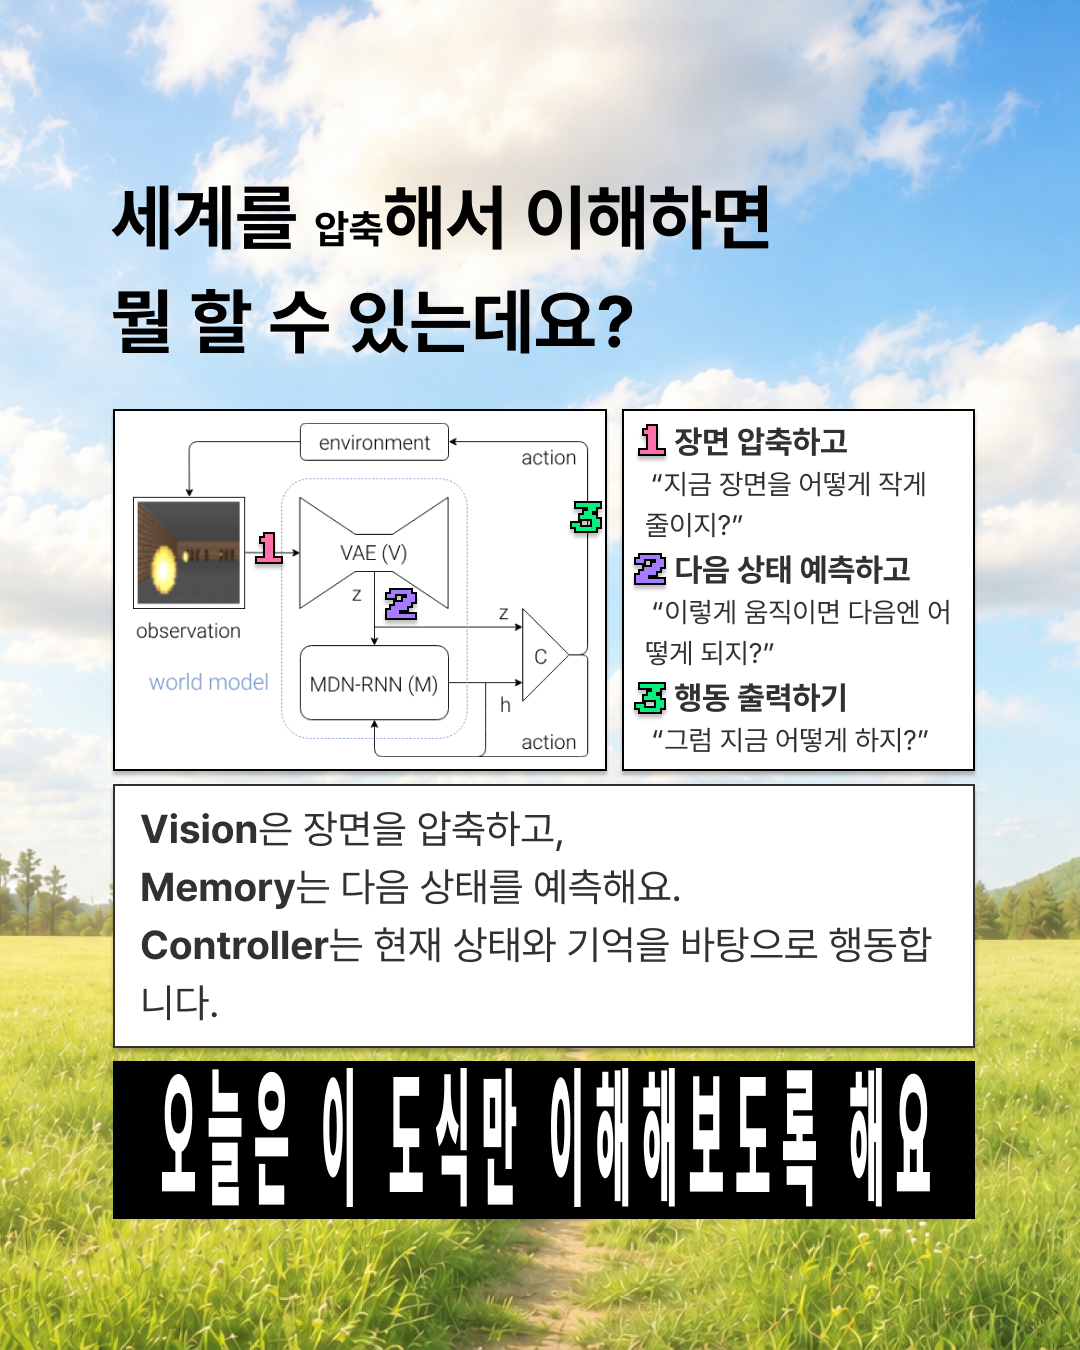
〈World Models〉는 이 압축과 예측을 세 부품으로 나눕니다.
- Vision — 지금 장면을 어떻게 작게 줄이지?
- Memory — 이렇게 움직이면 다음엔 어떻게 되지?
- Controller — 그럼 지금 어떻게 하지?
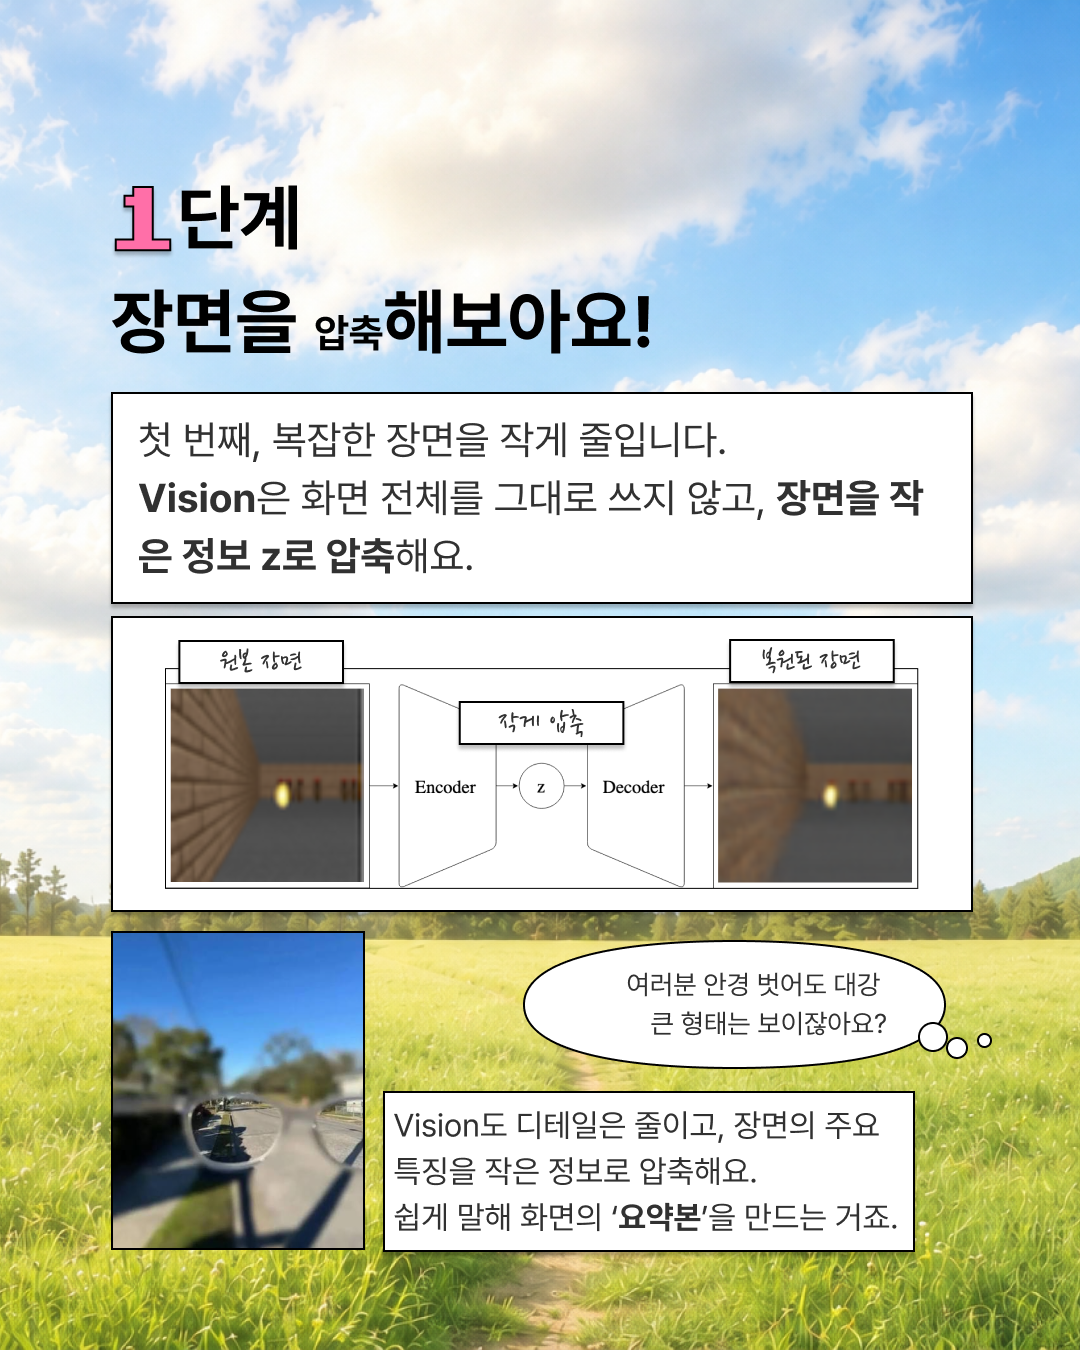
Vision은 장면을 압축하고, Memory는 다음 상태를 예측해요. Controller는 현재 상태와 기억을 바탕으로 행동합니다.
1단계 — 장면을 압축해요
Vision은 화면 전체를 그대로 쓰지 않고, 장면을 작은 정보 z로 압축합니다. 안경을 벗어도 큰 형태는 대강 보이는 것처럼, 디테일은 줄이고 주요 특징만 남기는 화면의 ’요약본’을 만드는 거죠.
2단계 — 다음 장면을 예측해요
Memory는 현재 상태와 행동을 보고, 다음 상태가 어떻게 변할지 예측합니다. 시간의 변화를 배우는 단계예요.
모기의 몸통과 날개 일부만 그려져 있어도 다음 선이 어떻게 이어질지 여러 형태로 예측할 수 있는 것과 같은 원리입니다.
3단계 — 이제는 행동을 선택해요
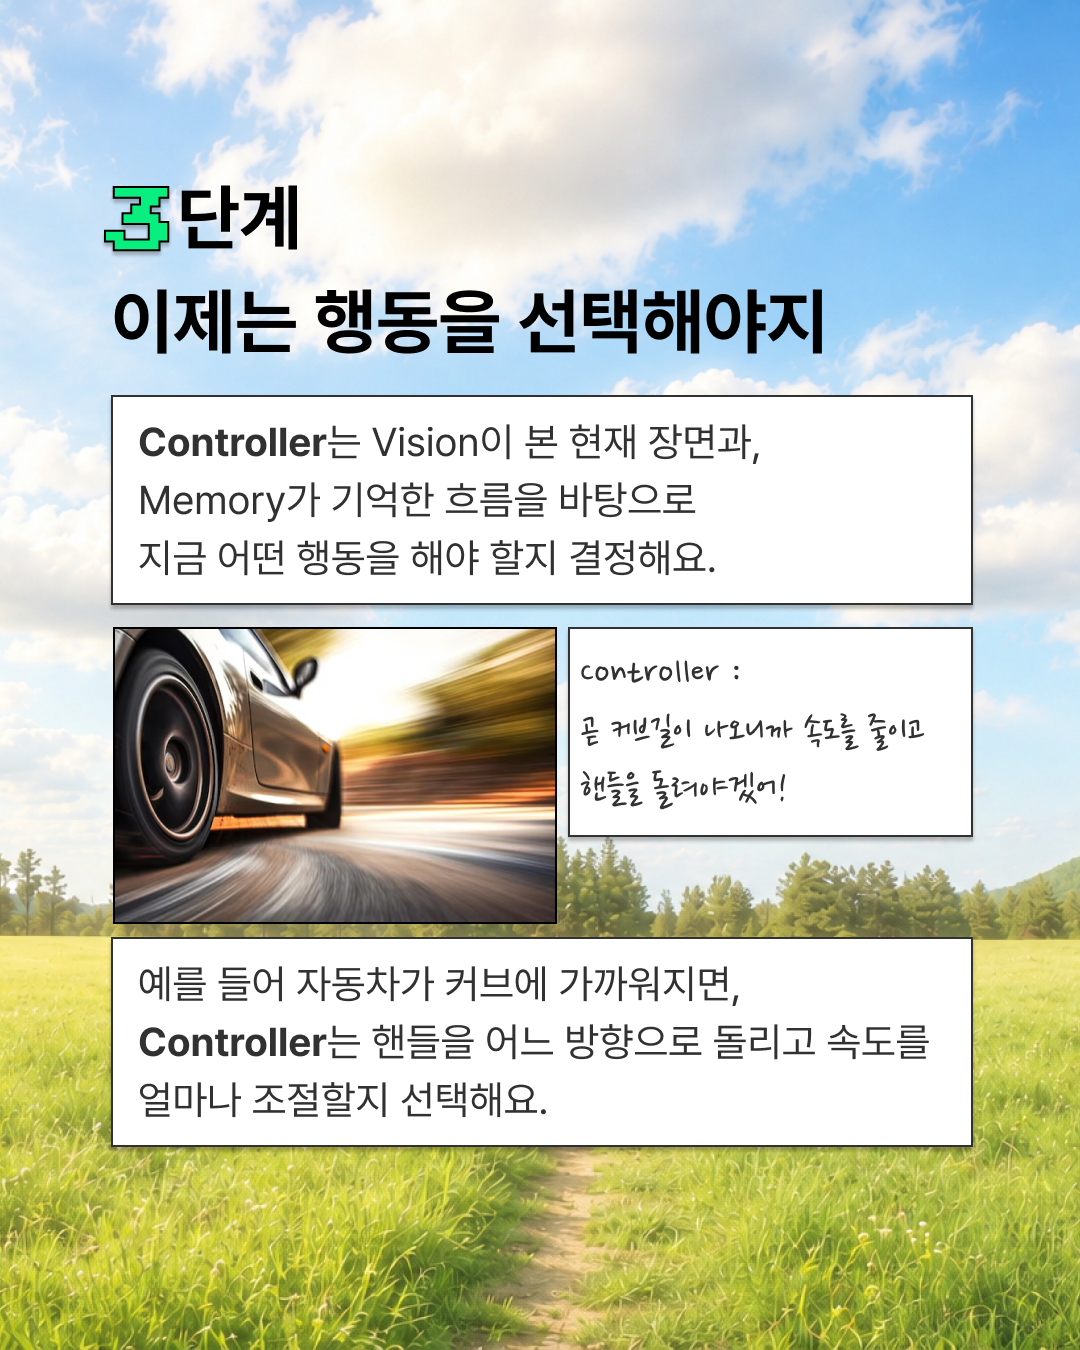
Controller는 Vision이 본 현재 장면과 Memory가 기억한 흐름을 바탕으로 지금 어떤 행동을 해야 할지 결정합니다.
예를 들어 자동차가 커브에 가까워지면, Controller는 핸들을 어느 방향으로 돌리고 속도를 얼마나 조절할지 선택해요.
지금 이 구조로 어디까지 왔나
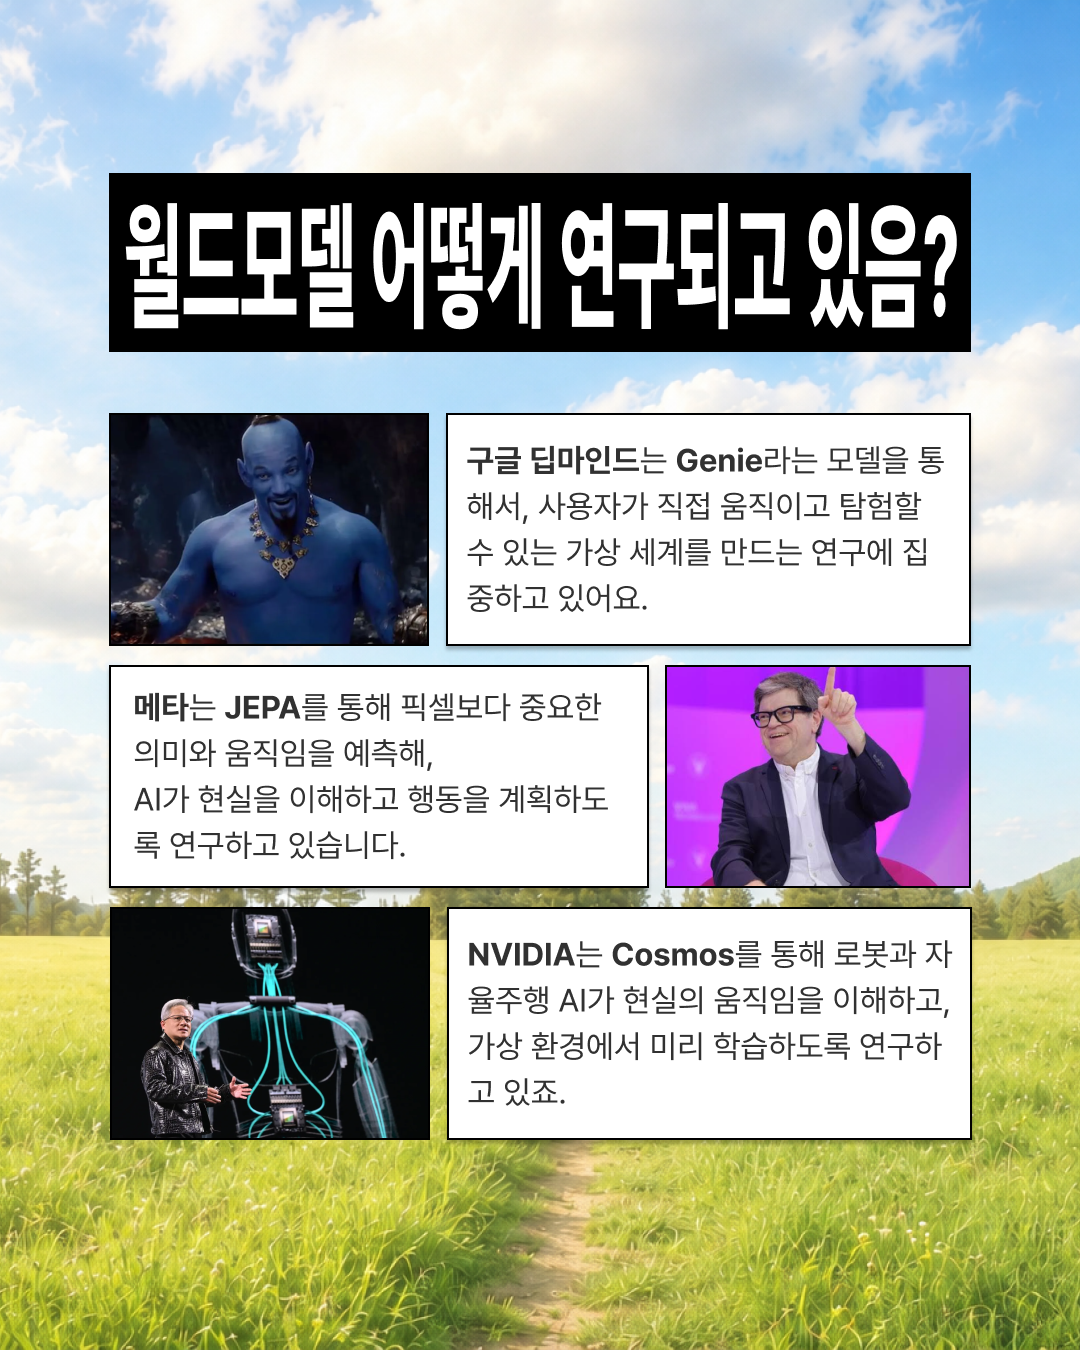
- 구글 딥마인드는 Genie로, 사용자가 직접 움직이고 탐험할 수 있는 가상 세계를 만드는 연구에 집중하고 있습니다.
- 메타는 JEPA로 픽셀보다 중요한 의미와 움직임을 예측해, AI가 현실을 이해하고 행동을 계획하도록 연구하고 있습니다.
- NVIDIA는 Cosmos로 로봇과 자율주행 AI가 현실의 움직임을 이해하고, 가상 환경에서 미리 학습하도록 연구하고 있습니다.
세 회사 모두 같은 뼈대 — 압축하고, 예측하고, 행동하는 — 위에서 각자의 답을 찾고 있습니다.
태그
- #인공지능
- #AI논문
- #테크뉴스