마이크로덕으로 알아보는 강화학습과 Sim-to-real
Reinforcement Learning and Sim-to-Real Explained Using MicroDuck
“아장아장 걷는 오리 로봇, 본 적 있으신가요?”
SNS나 릴스에서 아장아장 걷는 작은 오리 로봇, 바로 Microduck입니다. 귀여운 외형과 달리, 이 로봇은 가상세계에서 수많은 시행착오를 거치며 걷는 법을 배웠습니다.
그런데 컴퓨터 안에서 잘 걷는 것과 현실에서 넘어지지 않는 것은 전혀 다른 문제죠.
두 발로 걷는 건 생각보다 어려워요. 한 발을 들면 무게중심이 바뀌고, 발이 바닥에 닿는 순간 충격이 생기죠. 이걸 사람이 하나하나 설계하려면 관절의 움직임부터 몸의 기울기까지 일일이 계산해야 합니다.
그래서 최근 로봇 학습은 다른 질문을 던져요. 정답인 걸음걸이를 알려주는 대신, 로봇 스스로 걷는 방법을 찾게 할 수는 없을까요? Pollen Robotics와 Hugging Face의 오픈소스 이족보행 로봇 Microduck이 좋은 사례입니다.
Microduck은 어떻게 움직이는가
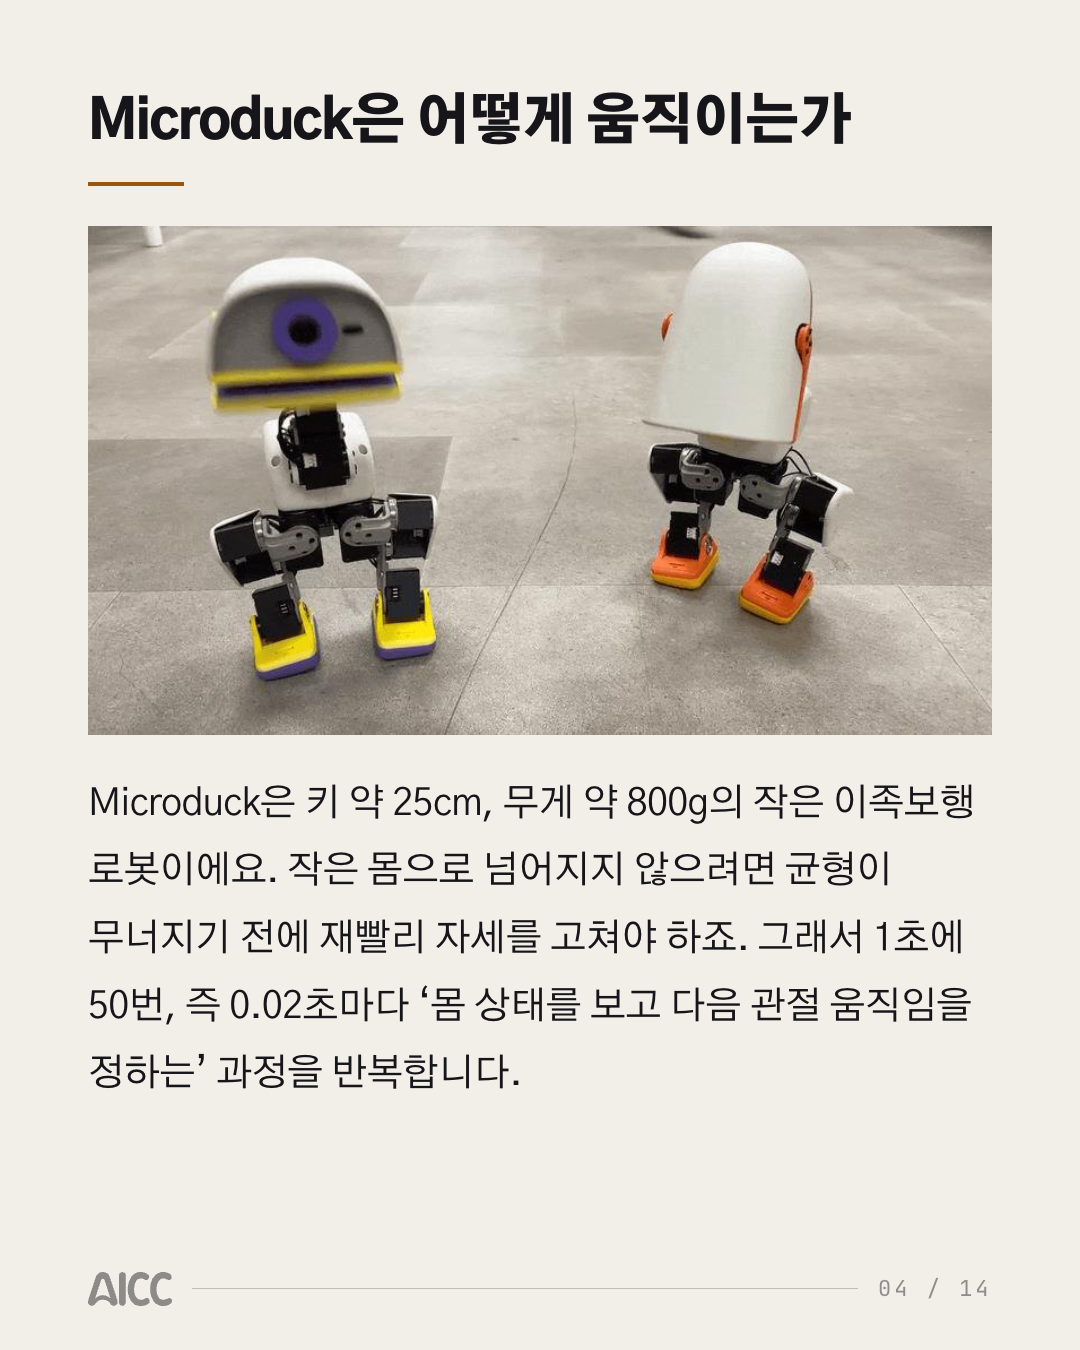
Microduck은 키 약 25cm, 무게 약 800g의 작은 이족보행 로봇이에요. 작은 몸으로 넘어지지 않으려면 균형이 무너지기 전에 재빨리 자세를 고쳐야 하죠. 그래서 1초에 50번, 즉 0.02초마다 ‘몸 상태를 보고 다음 관절 움직임을 정하는’ 과정을 반복합니다.
이 판단을 맡는 것이 정책(policy)이라는 신경망이에요. 정책은 시뮬레이션에서 PPO(Proximal Policy Optimization)라는 강화학습 알고리즘으로 학습한 뒤, ONNX라는 표준 파일 형식으로 저장해 실제 로봇에 옮깁니다.
정책은 매 순간 숫자 61개를 입력받아 숫자 14개를 내놓아요. 입력 중 48개는 관절 각도나 몸의 기울기처럼 로봇의 현재 상태이고, 13개는 ‘앞으로 얼마나 빨리 가라’ 같은 명령입니다. 출력 14개는 각 관절을 어디로 움직일지 정하는 목표값이죠.
그럼 이 정책에 걷는 법은 어떻게 가르칠까요? ‘왼발을 몇 도 들어라’ 같은 정답 대신, 목표 속도를 잘 따라가거나 넘어지지 않았을 때 보상(reward)을 줍니다.
보상을 잘 주면 걷는 법을 배울까?
“정답 대신 점수를 준다”
강화학습의 기본 구조는 단순해요. 로봇이 행동하면 환경이 점수를 돌려주고, 로봇은 더 높은 점수를 받도록 정책을 고쳐 나갑니다.
예를 들어 목표 속도에 가깝게 걸을수록 높은 점수를 주고, 넘어지거나 자세가 불안정하면 점수를 깎는 식이죠. (이는 원리를 설명하기 위한 예시로, Microduck의 실제 보상함수는 아니에요.)
그런데 여기서 재미있는 일이 벌어집니다. 높은 보상을 받는 행동이 꼭 우리가 원하는 걸음걸이는 아니에요. 로봇은 자연스러운 걸음 대신, 점수를 쉽게 받는 지름길을 찾아내기도 하거든요. 이를 reward hacking이라고 부릅니다.
빨리 걷는 것에만 점수를 주면 균형을 잃고, 안정성만 강조하면 아예 움직이지 않으려 할 수도 있어요. 우리가 원하는 건 높은 점수가 아니라, 현실에서도 유용한 걸음걸이니까요.
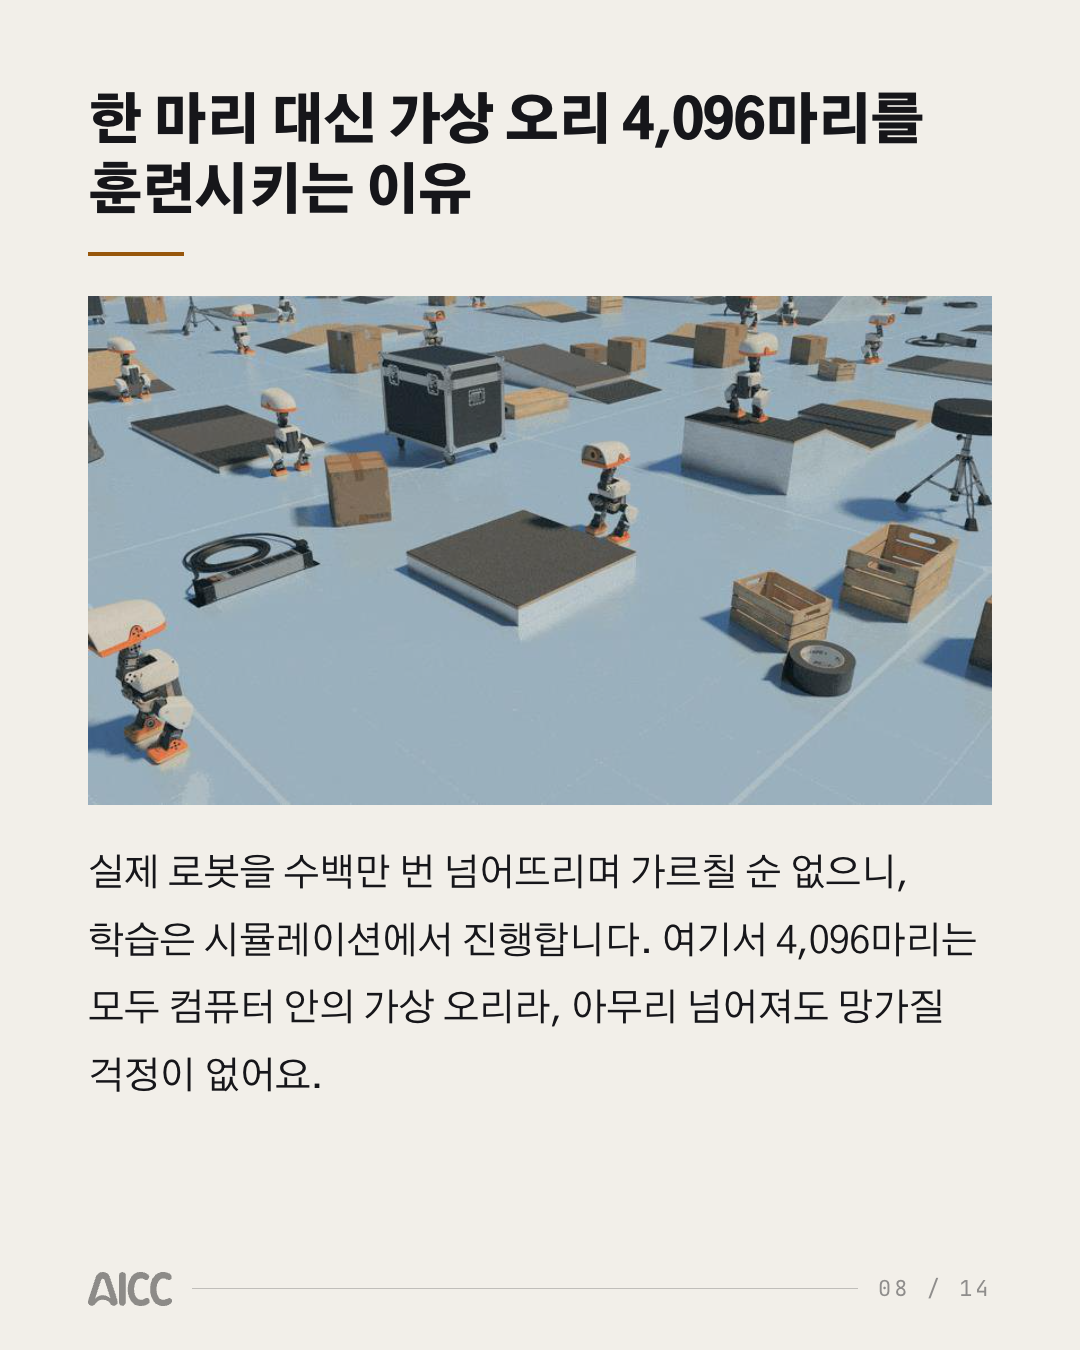
한 마리 대신 가상 오리 4,096마리를 훈련시키는 이유
실제 로봇을 수백만 번 넘어뜨리며 가르칠 순 없으니, 학습은 시뮬레이션에서 진행합니다. 여기서 4,096마리는 모두 컴퓨터 안의 가상 오리라, 아무리 넘어져도 망가질 걱정이 없어요.
Microduck 튜토리얼은 이 가상 오리 4,096마리를 GPU에서 동시에 걷게 하고, 각자 넘어지고 일어난 경험을 모아 하나의 보행 정책을 개선합니다. 한 마리가 혼자 수천 번 넘어질 경험을, 수천 마리가 한 번에 모아 오는 셈이에요. 비슷한 방식으로 네 발 로봇 ANYmal은 평지 보행을 4분도 안 돼 배웠다는 연구도 있죠.
PPO는 무엇을 바꾸는가
모은 경험으로 정책을 고치는 알고리즘이 PPO예요. 핵심은 한 번의 업데이트에 정책이 너무 급격하게 바뀌지 않게 하는 것입니다.
지금 가진 경험은 현재 정책으로 걸어 보며 모은 것이라, 정책이 크게 바뀌면 그 경험이 더 이상 맞지 않아요. 무리하게 고치면 잘 걷던 로봇이 넘어지기만 하는 정책으로 무너질 수도 있죠. 그래서 PPO는 변화 폭에 상한선을 두고 조금씩 개선합니다.
물론 PPO만 잘 쓴다고 로봇이 잘 걷는 건 아니에요. 관측과 행동, 보상, 시뮬레이터의 현실성까지 모두 중요합니다.
가상세계에서는 잘 걷는데, 현실에서는 왜 넘어질까?
“가상과 현실 사이의 틈, Sim-to-Real”
수천 마리의 가상 오리가 잘 걷기 시작했어요. 이제 진짜 로봇에 옮기면 끝일까요? 아직 가장 까다로운 단계, Sim-to-Real이 남았습니다.
시뮬레이션 속 모터는 원하는 각도대로 정확히 움직이지만, 현실의 모터에는 마찰과 힘의 한계가 있어요. 명령은 늦게 도착하기도 하고 배터리 전압도 계속 변하죠. 맞물린 기어 사이의 작은 틈, 기어 유격(backlash) 때문에 관절이 살짝 늦게 따라오기도 합니다. 한 발로 균형을 잡는 순간엔 이런 작은 차이도 넘어짐으로 이어져요.
그래서 튜토리얼은 먼저 BAM(Better Actuator Models)으로 가상 모터를 실제 모터에 가깝게 만듭니다. 실제 서보모터로 측정한 데이터를 바탕으로 마찰을 더 정확하게 표현하고, backlash도 반영하죠.
또 가상 오리마다 무게, 바닥 마찰, 배터리 전압, 명령 지연을 조금씩 바꾸고 지형과 외부 충격까지 더해요. 이를 Domain Randomization이라고 합니다. 한 가지 가상세계에만 익숙해지지 않고, 여러 조건에서 버티도록 훈련하는 거죠.
“이제는 여러분 차례예요”
‘강화학습만 시키면 로봇이 걷는구나’라고 생각할 수도 있지만, 실제로는 훨씬 많은 과정이 숨어 있어요. 보상 설계, 빠른 데이터 수집, 현실적인 모터 모델, 다양한 환경에서의 학습, 정확한 배포가 함께 맞아떨어져야 합니다.
물론 남은 과제도 있어요. 지금의 Microduck은 주어진 학습 목표대로 걷는 법을 익힌 것이라, 처음 겪는 지형이나 상황에서도 잘 걸을지는 또 다른 문제죠.
과거에는 정교한 보행 연구를 하려면 특수한 하드웨어와 자체 시뮬레이션 환경이 필요했어요. 지금은 작은 오픈소스 로봇과 공개된 학습 코드로 ‘시뮬레이션에서 배우고, 현실에서 검증하는 과정’을 누구나 직접 따라가 볼 수 있습니다.
태그
- #인공지능
- #AI논문
- #HuggingFace
- #Microduck
- #Sim-to-real